컨텍스트 윈도우: 긴 대화에서 AI는 왜 앞에서 한 말을 놓칠까
카드 텍스트 보기
오래 가는 진짜 AI 기본기 알아야 보인다 context window 컨텍스트 윈도우 AI가 한 번에 펼쳐 볼 수 있는 글의 양 Q 긴 대화에서 AI는 왜 앞에서 한 말을 놓칠까요? 01 / 07
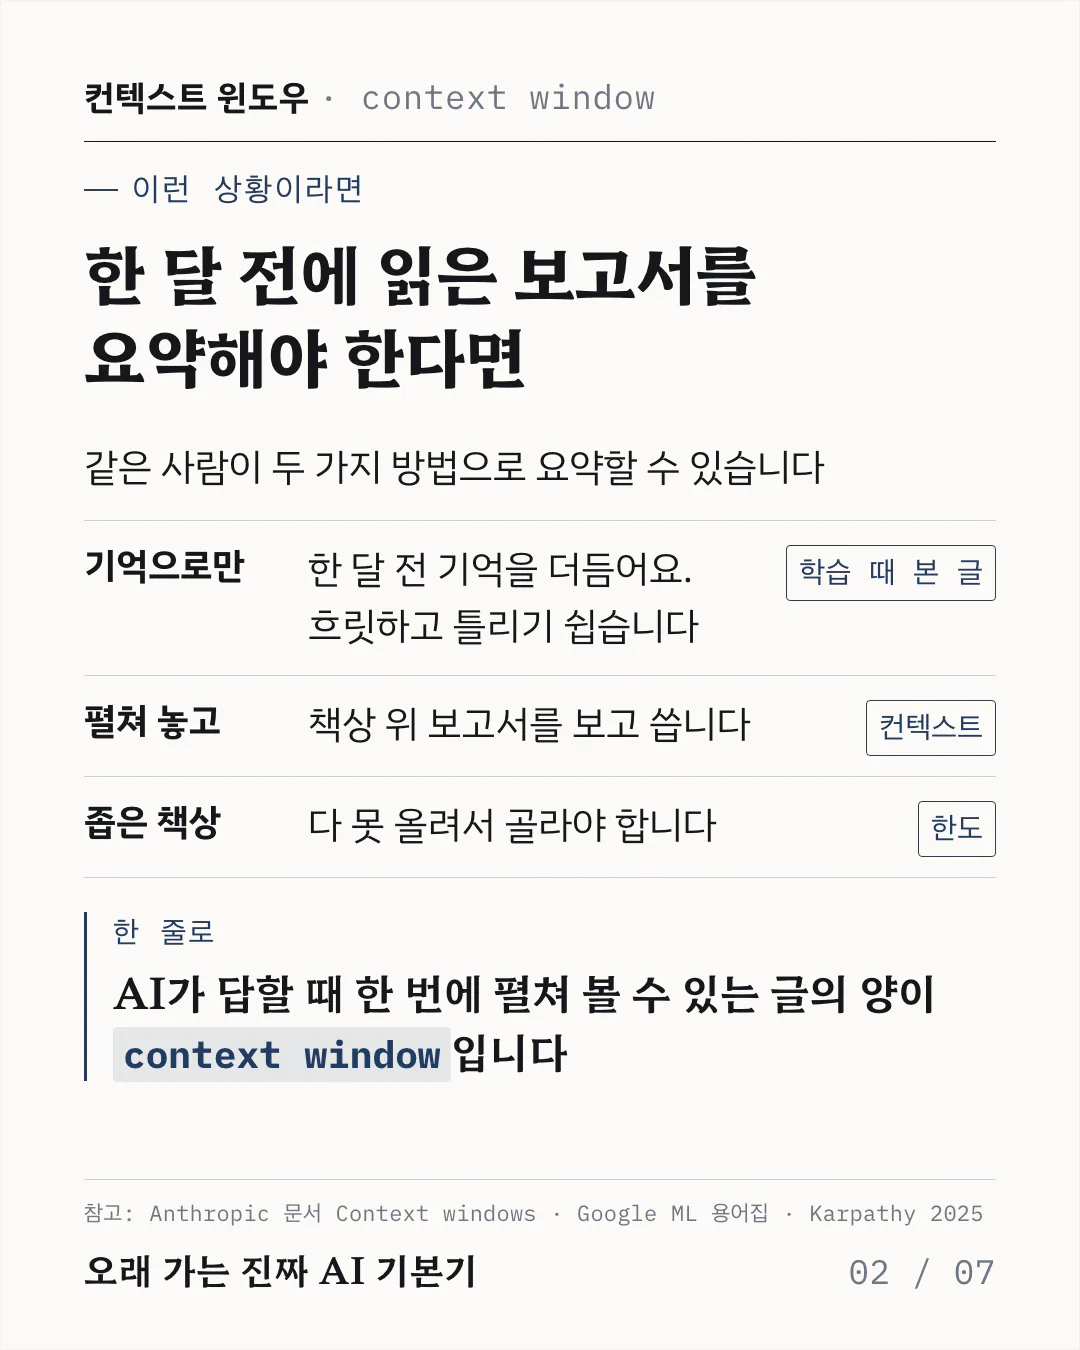
기억으로 쓸 때와 책상에 펴 놓고 쓸 때
비유가 어긋나는 곳도 있어요. 사람은 책상에서 읽은 걸 기억에 남기지만, 모델은 대화가 끝나면 책상을 통째로 비우거든요. 다음 대화는 빈 책상에서 다시 시작하죠.
카드 텍스트 보기
컨텍스트 윈도우 · context window 이런 상황이라면 한 달 전에 읽은 보고서를 요약해야 한다면 같은 사람이 두 가지 방법으로 요약할 수 있습니다 기억으로만 한 달 전 기억을 더듬어요. 흐릿하고 틀리기 쉽습니다 학습 때 본 글 펼쳐 놓고 책상 위 보고서를 보고 씁니다 컨텍스트 좁은 책상 다 못 올려서 골라야 합니다 한도 한 줄로 AI가 답할 때 한 번에 펼쳐 볼 수 있는 글의 양이 context window 입니다 참고: Anthropic 문서 Context windows · Google ML 용어집 · Karpathy 2025 오래 가는 진짜 AI 기본기 02 / 07
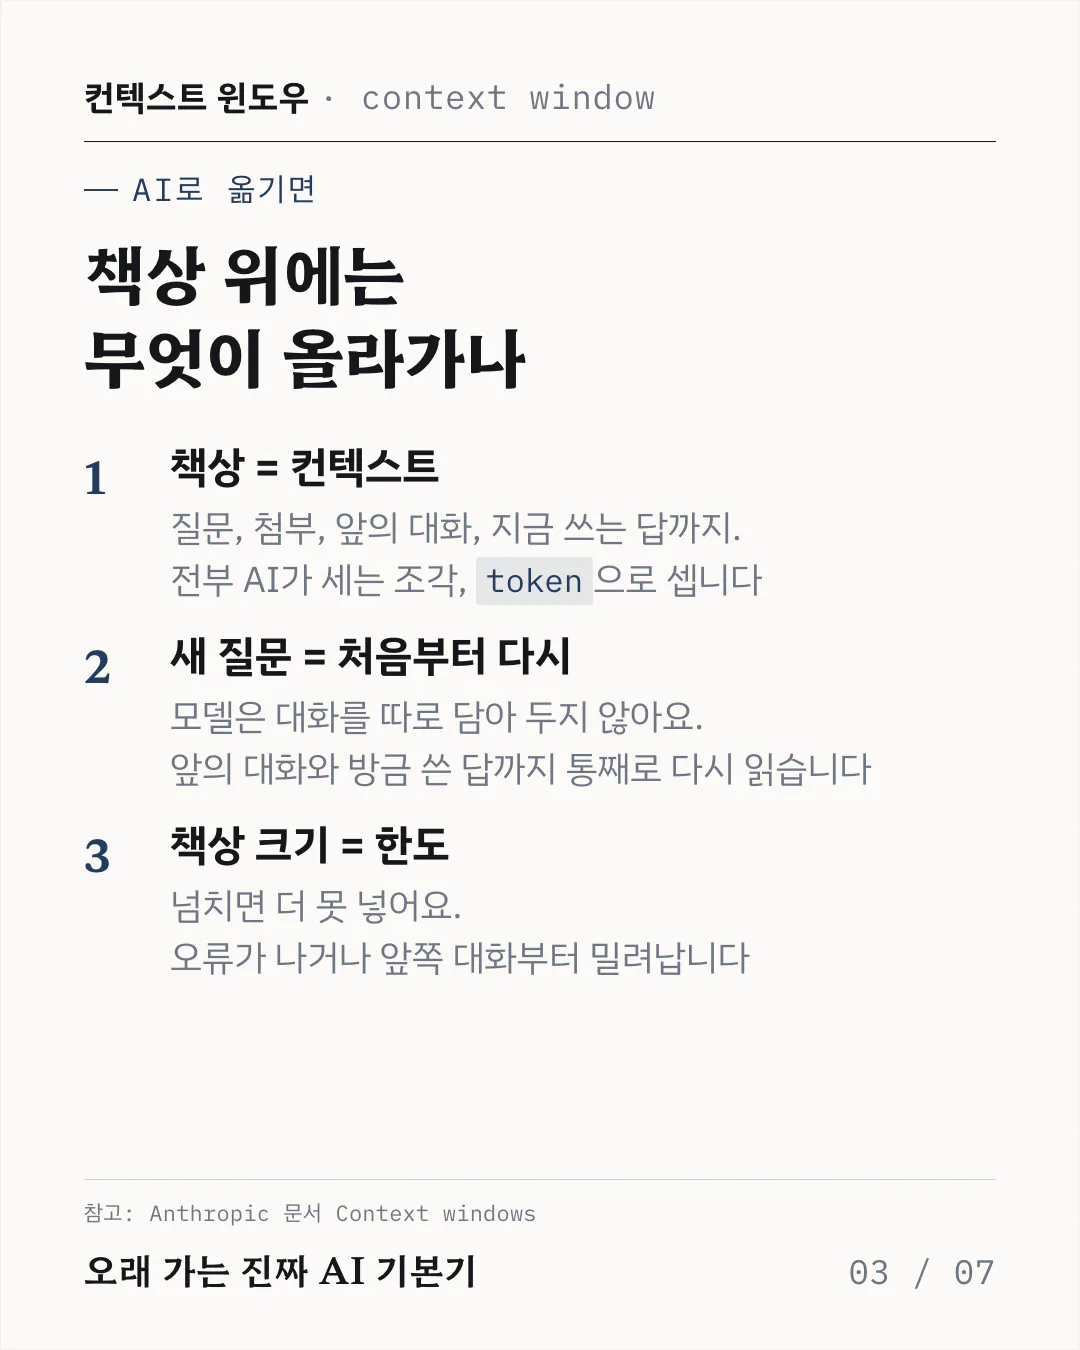
책상 위에 올라가는 것들
한도를 넘으면 어떻게 될지는 쓰는 곳마다 달라요. Anthropic 문서를 보면 API 는 'prompt is too long' 오류를 내고, 채팅 화면은 오래된 대화부터 밀어내는 방식을 쓰기도 해요.
카드 텍스트 보기
컨텍스트 윈도우 · context window AI로 옮기면 책상 위에는 무엇이 올라가나 1 책상 = 컨텍스트 질문, 첨부, 앞의 대화, 지금 쓰는 답까지. 전부 AI가 세는 조각, token 으로 셉니다 2 새 질문 = 처음부터 다시 모델은 대화를 따로 담아 두지 않아요. 앞의 대화와 방금 쓴 답까지 통째로 다시 읽습니다 3 책상 크기 = 한도 넘치면 더 못 넣어요. 오류가 나거나 앞쪽 대화부터 밀려납니다 참고: Anthropic 문서 Context windows 오래 가는 진짜 AI 기본기 03 / 07
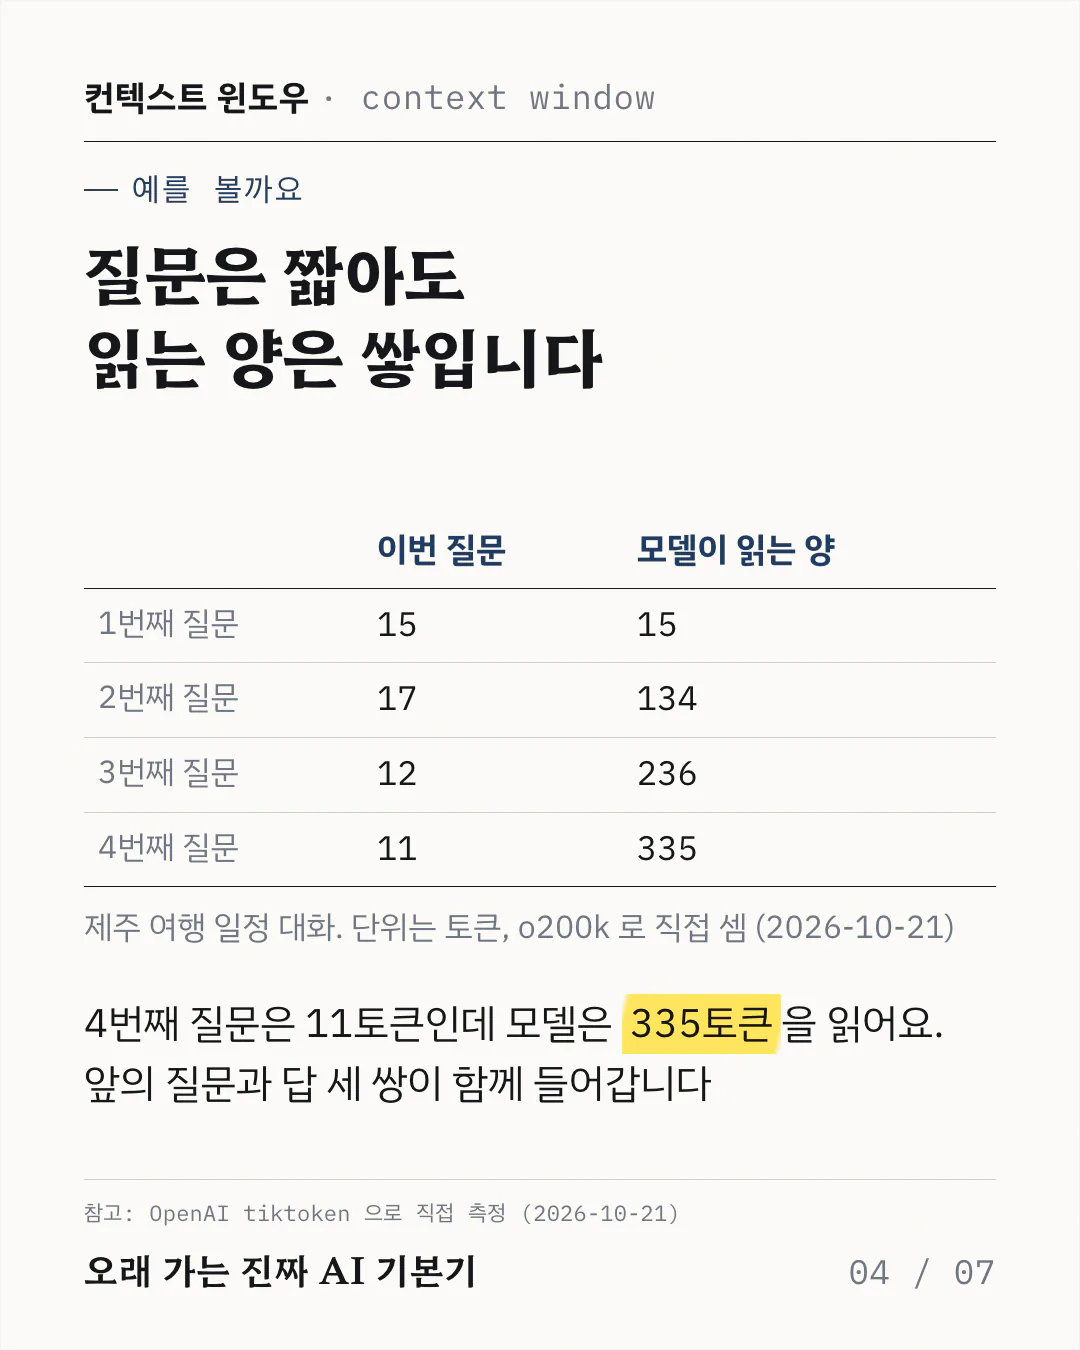
질문은 짧아도 쌓이는 토큰
표의 숫자는 대화 글만 센 거예요. API 로 쓰면 시스템 프롬프트와 도구 설명도 같은 한도 안에서 세니까 실제로 읽는 양은 더 많죠. 대화 네 차례를 OpenAI o200k 토크나이저로 직접 세 봤어요.
카드 텍스트 보기
컨텍스트 윈도우 · context window 예를 볼까요 질문은 짧아도 읽는 양은 쌓입니다 이번 질문 모델이 읽는 양 1번째 질문 15 15 2번째 질문 17 134 3번째 질문 12 236 4번째 질문 11 335 제주 여행 일정 대화. 단위는 토큰, o200k 로 직접 셈 (2026-10-21) 4번째 질문은 11토큰인데 모델은 335토큰 을 읽어요. 앞의 질문과 답 세 쌍이 함께 들어갑니다 참고: OpenAI tiktoken 으로 직접 측정 (2026-10-21) 오래 가는 진짜 AI 기본기 04 / 07
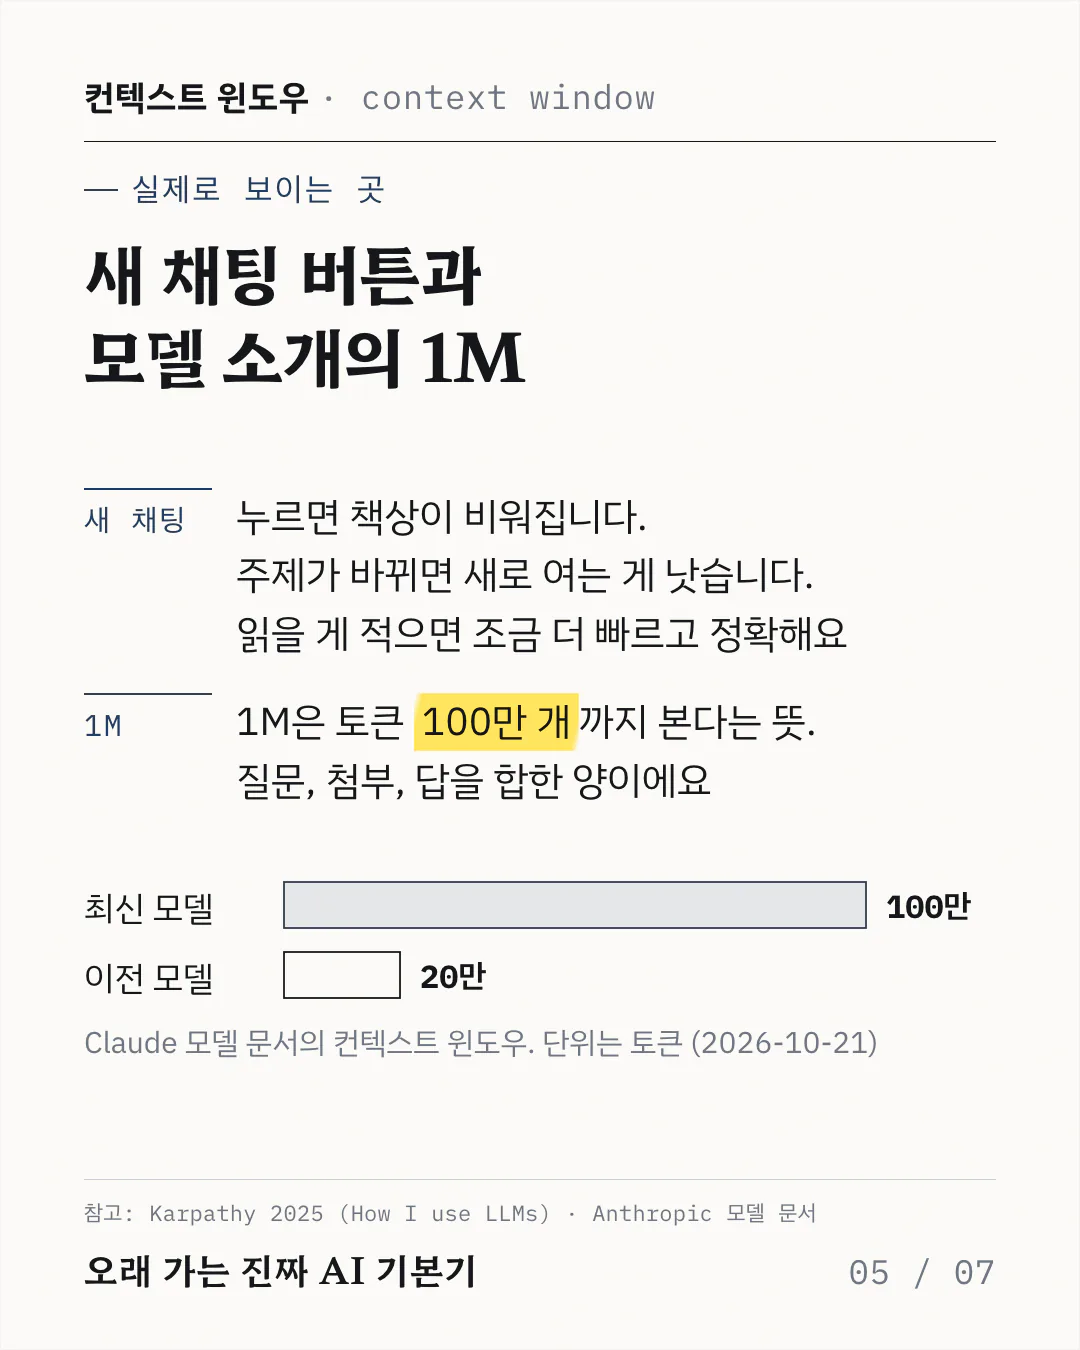
새 채팅 버튼과 모델 소개에서 만나는 컨텍스트 윈도우
Karpathy 는 주제가 바뀔 때마다 새 채팅을 열라고 권해요. 앞의 토큰이 많으면 모델이 흐트러지고 다음 토큰을 만드는 계산도 조금씩 비싸지거든요. 이어 가야 할 내용은 요약해서 새 채팅에 붙이면 돼요.
카드 텍스트 보기
컨텍스트 윈도우 · context window 실제로 보이는 곳 새 채팅 버튼과 모델 소개의 1M 새 채팅 누르면 책상이 비워집니다. 주제가 바뀌면 새로 여는 게 낫습니다. 읽을 게 적으면 조금 더 빠르고 정확해요 1M 1M은 토큰 100만 개 까지 본다는 뜻. 질문, 첨부, 답을 합한 양이에요 최신 모델 100만 이전 모델 20만 Claude 모델 문서의 컨텍스트 윈도우. 단위는 토큰 (2026-10-21) 참고: Karpathy 2025 (How I use LLMs) · Anthropic 모델 문서 오래 가는 진짜 AI 기본기 05 / 07
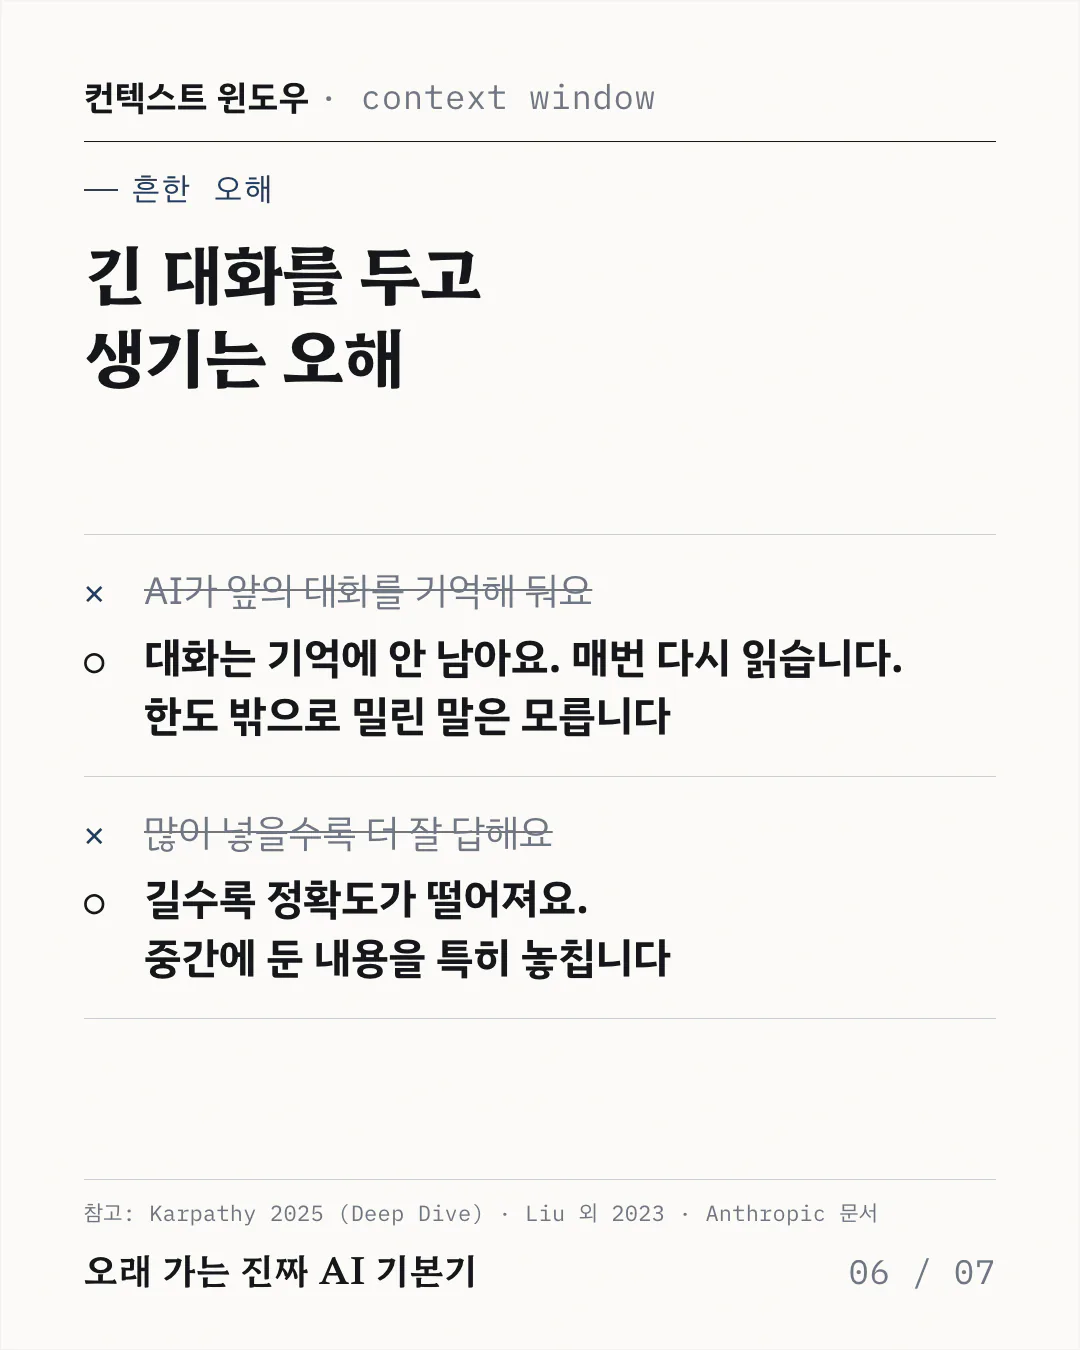
긴 대화를 두고 생기는 오해
대화가 끝나도 무언가 남게 하려면 따로 적어 둬야 해요. Anthropic 은 에이전트가 메모를 적어 두었다가 나중에 컨텍스트에 다시 불러오는 방법을 소개하거든요. 모델이 보는 건 결국 이번 책상에 올라온 글이죠.
카드 텍스트 보기
컨텍스트 윈도우 · context window 흔한 오해 긴 대화를 두고 생기는 오해 ✕ AI가 앞의 대화를 기억해 둬요 ○ 대화는 기억에 안 남아요. 매번 다시 읽습니다. 한도 밖으로 밀린 말은 모릅니다 ✕ 많이 넣을수록 더 잘 답해요 ○ 길수록 정확도가 떨어져요. 중간에 둔 내용을 특히 놓칩니다 참고: Karpathy 2025 (Deep Dive) · Liu 외 2023 · Anthropic 문서 오래 가는 진짜 AI 기본기 06 / 07
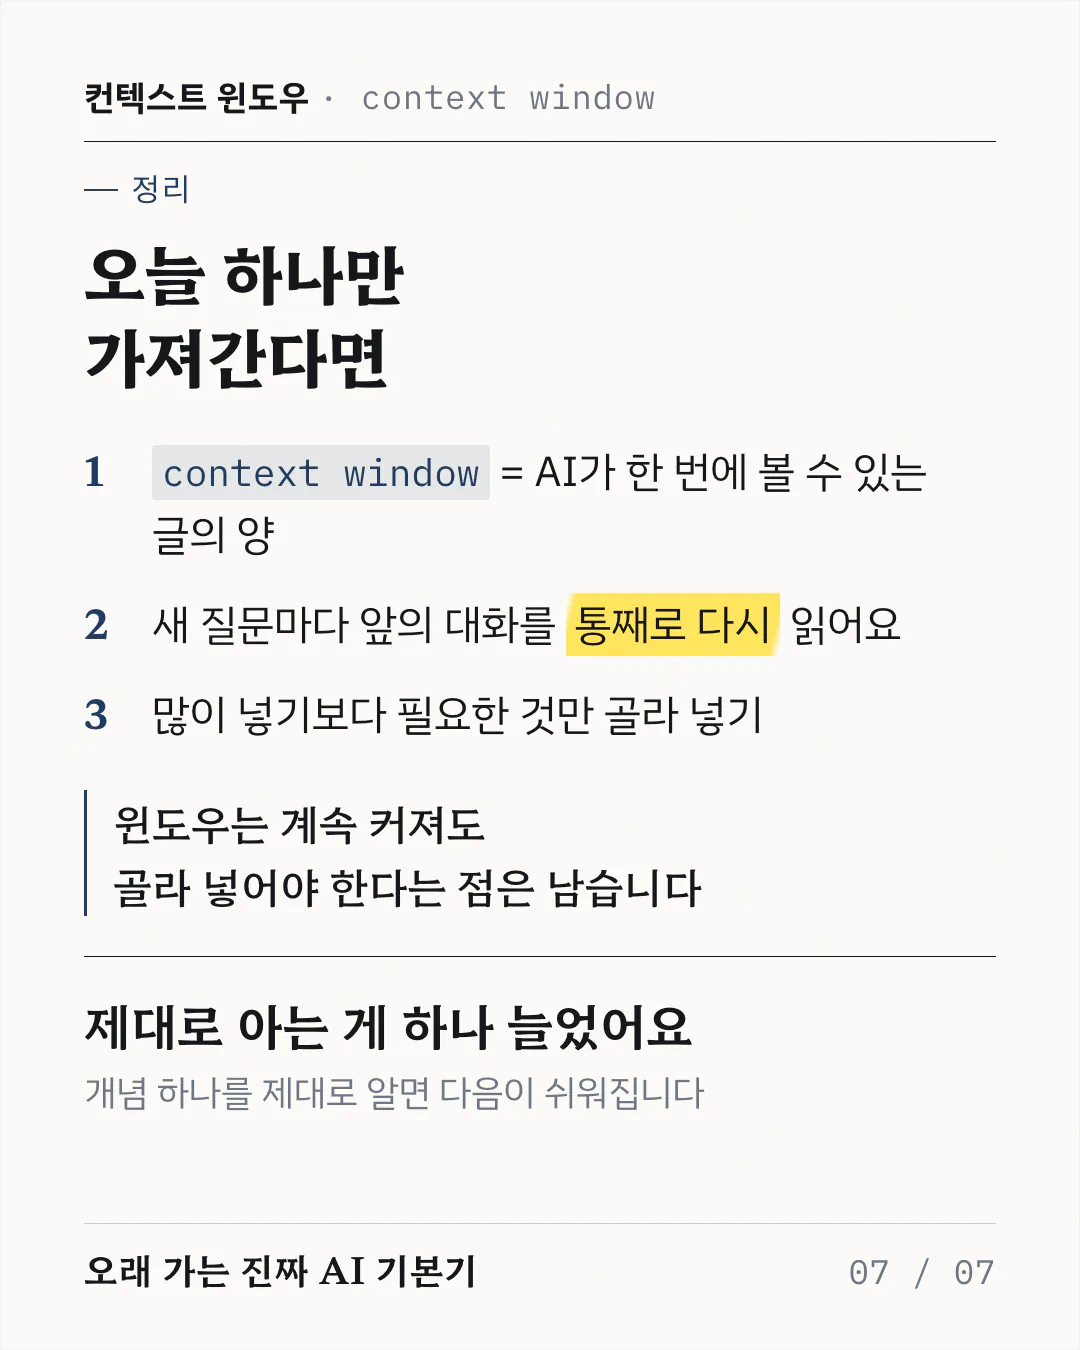
오늘 기억할 세 가지
세 번째 줄을 Anthropic 은 컨텍스트 엔지니어링이라고 불러요. 원하는 답에 꼭 필요한 토큰을 가장 적게 골라 넣는 일이라고 설명하죠. 윈도우가 커져도 이 감각은 낡지 않아요.
카드 텍스트 보기
컨텍스트 윈도우 · context window 정리 오늘 하나만 가져간다면 1 context window = AI가 한 번에 볼 수 있는 글의 양 2 새 질문마다 앞의 대화를 통째로 다시 읽어요 3 많이 넣기보다 필요한 것만 골라 넣기 윈도우는 계속 커져도 골라 넣어야 한다는 점은 남습니다 제대로 아는 게 하나 늘었어요 개념 하나를 제대로 알면 다음이 쉬워집니다 오래 가는 진짜 AI 기본기 07 / 07
출처
- Anthropic 문서 Context windows
- Anthropic, Effective context engineering for AI agents
- Google 머신러닝 용어집
- Andrej Karpathy, Deep Dive into LLMs like ChatGPT (2025)
- Andrej Karpathy, How I use LLMs (2025)
- Liu 외, Lost in the Middle: How Language Models Use Long Contexts (2023)
- OpenAI tiktoken README
표의 토큰 수는 tiktoken 0.14 (o200k_base) 로 2026-10-21 에 직접 셌어요. 대화는 예시로 직접 쓴 거예요.
컨텍스트 윈도우란 무엇일까
컨텍스트 윈도우를 알면 요금과 속도, 답의 정확도가 한꺼번에 설명돼요. 대화가 길어질 때 셋이 같이 움직이거든요. AI를 쓰는 습관이 바뀌는 개념이죠.