ChatGPT 요금은 왜 글자 수가 아니라 토큰으로 매길까
카드 텍스트 보기
오래 가는 진짜 AI 기본기 알아야 보인다 token 토큰 글자도 단어도 아닌, AI가 글을 세는 단위 Q ChatGPT 요금은 왜 글자 수가 아니라 토큰으로 매길까요? 01 / 07
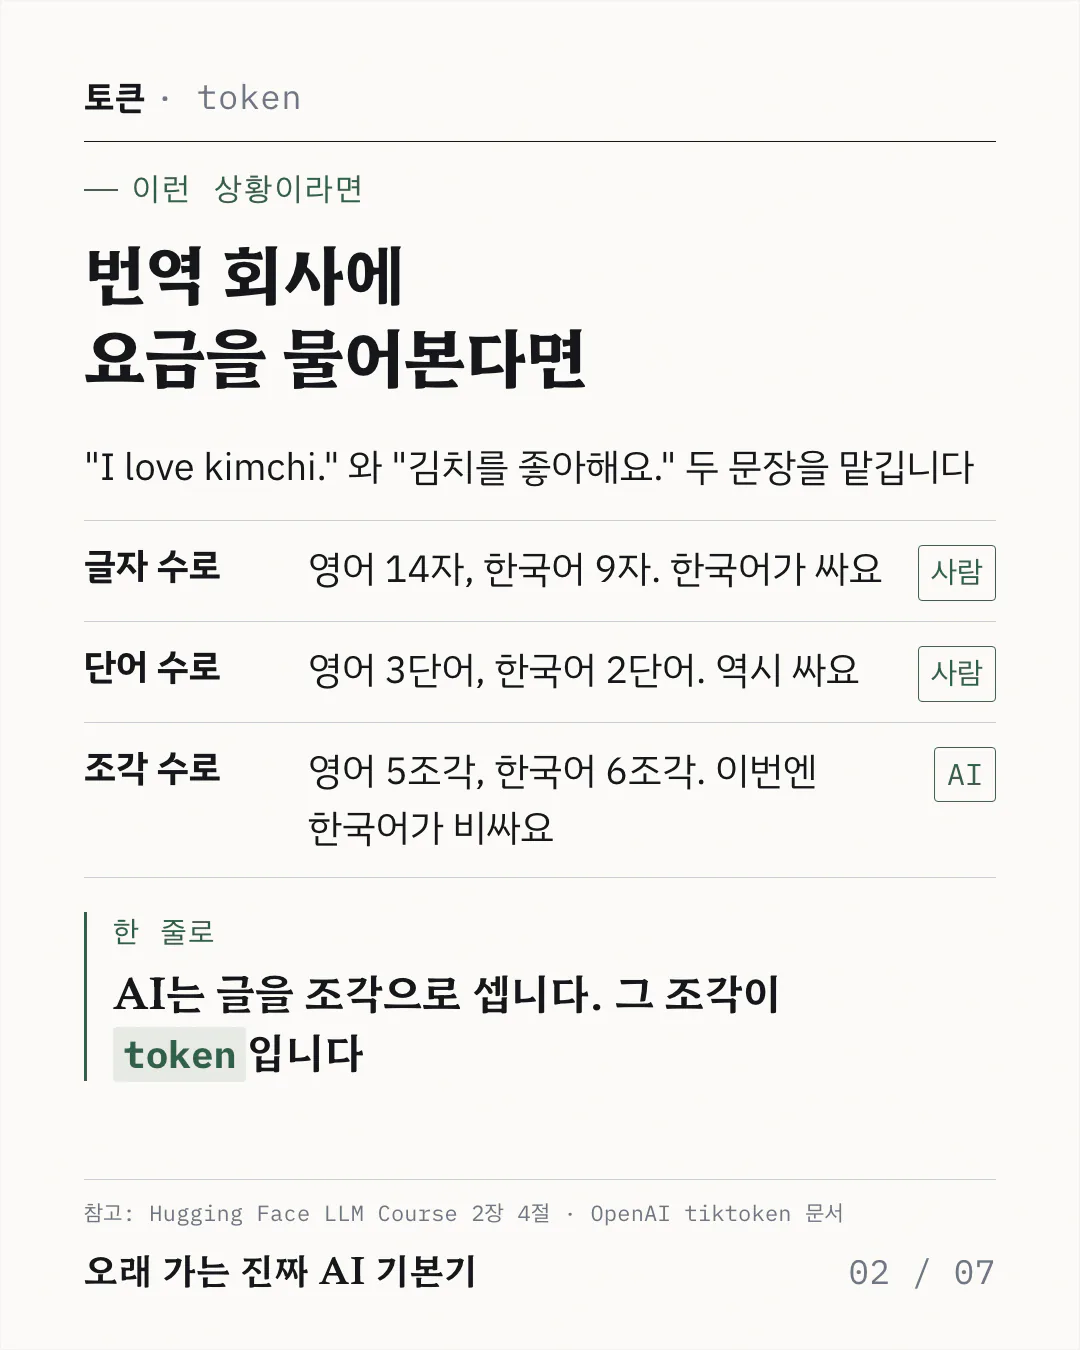
글자 수도 단어 수도 아닌 세 번째 기준
글자 수와 단어 수는 사람이 정한 단위예요. 반면에 토큰은 학습 데이터의 통계가 정했어요. 그래서 우리 직관과 어긋나는 지점이 생기죠. 이 카드의 숫자는 OpenAI o200k 로 직접 세 봤어요.
카드 텍스트 보기
토큰 · token 이런 상황이라면 번역 회사에 요금을 물어본다면 "I love kimchi." 와 "김치를 좋아해요." 두 문장을 맡깁니다 글자 수로 영어 14자, 한국어 9자. 한국어가 싸요 사람 단어 수로 영어 3단어, 한국어 2단어. 역시 싸요 사람 조각 수로 영어 5조각, 한국어 6조각. 이번엔 한국어가 비싸요 AI 한 줄로 AI는 글을 조각으로 셉니다. 그 조각이 token 입니다 참고: Hugging Face LLM Course 2장 4절 · OpenAI tiktoken 문서 오래 가는 진짜 AI 기본기 02 / 07
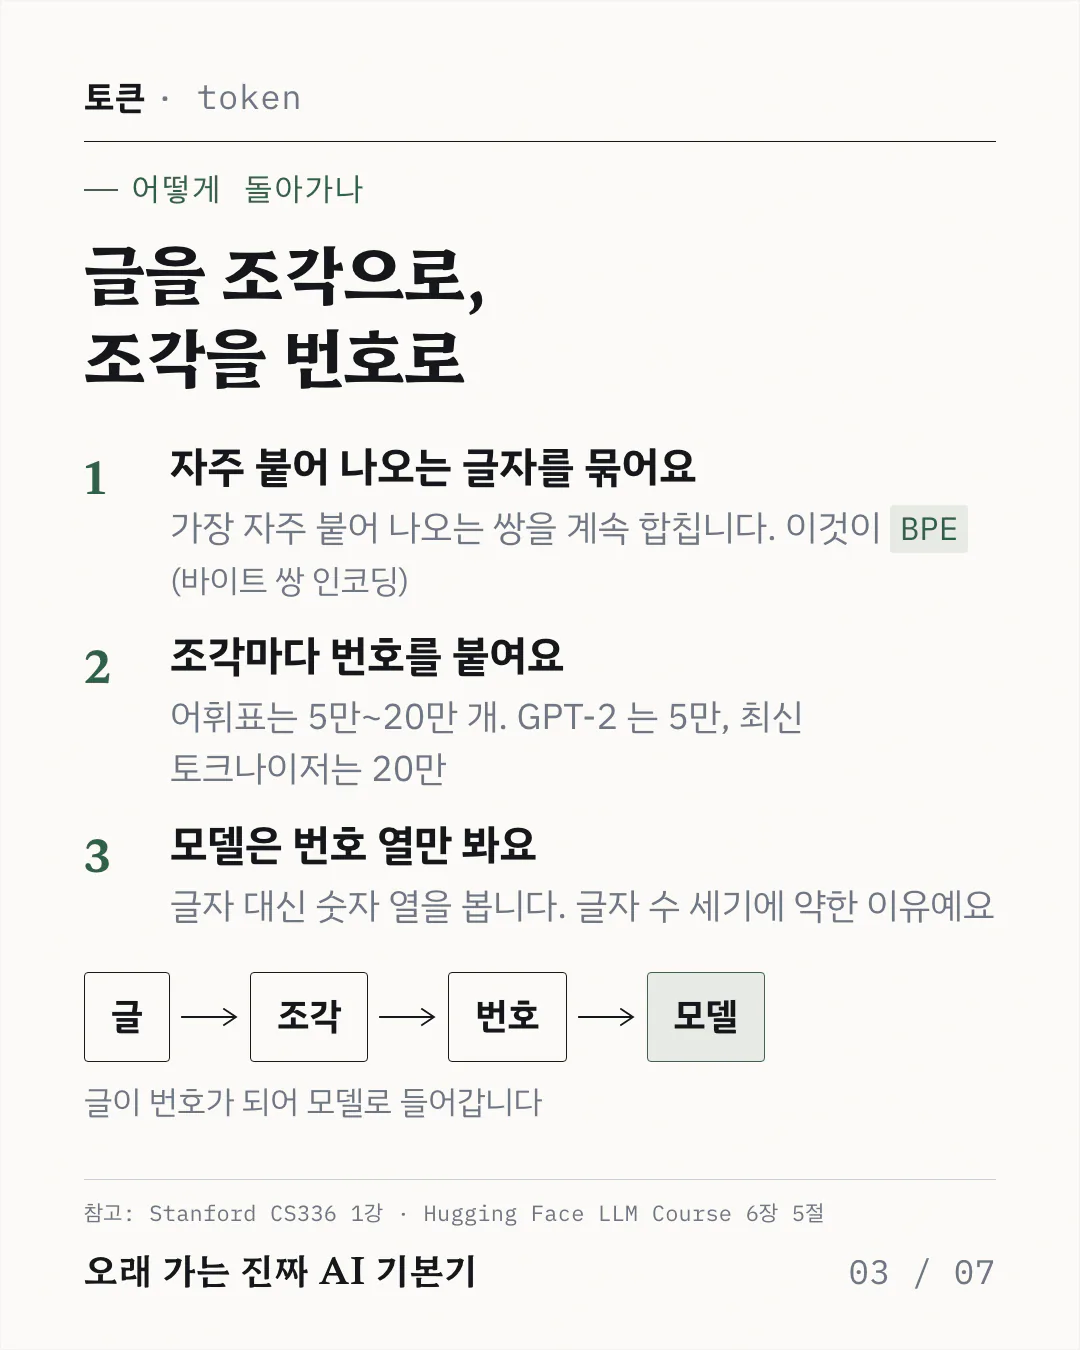
글이 번호가 되기까지
BPE 는 바이트 256개에서 출발해요. 거기서 가장 자주 붙어 나오는 쌍을 하나로 합치고, 어휘표가 찰 때까지 이걸 반복하죠. 그러니 자주 쓰는 단어는 한 조각으로 남고, 드문 단어는 여러 조각이 돼요.
카드 텍스트 보기
토큰 · token 어떻게 돌아가나 글을 조각으로, 조각을 번호로 1 자주 붙어 나오는 글자를 묶어요 가장 자주 붙어 나오는 쌍을 계속 합칩니다. 이것이 BPE (바이트 쌍 인코딩) 2 조각마다 번호를 붙여요 어휘표는 5만~20만 개. GPT-2 는 5만, 최신 토크나이저는 20만 3 모델은 번호 열만 봐요 글자 대신 숫자 열을 봅니다. 글자 수 세기에 약한 이유예요 글 조각 번호 모델 글이 번호가 되어 모델로 들어갑니다 참고: Stanford CS336 1강 · Hugging Face LLM Course 6장 5절 오래 가는 진짜 AI 기본기 03 / 07
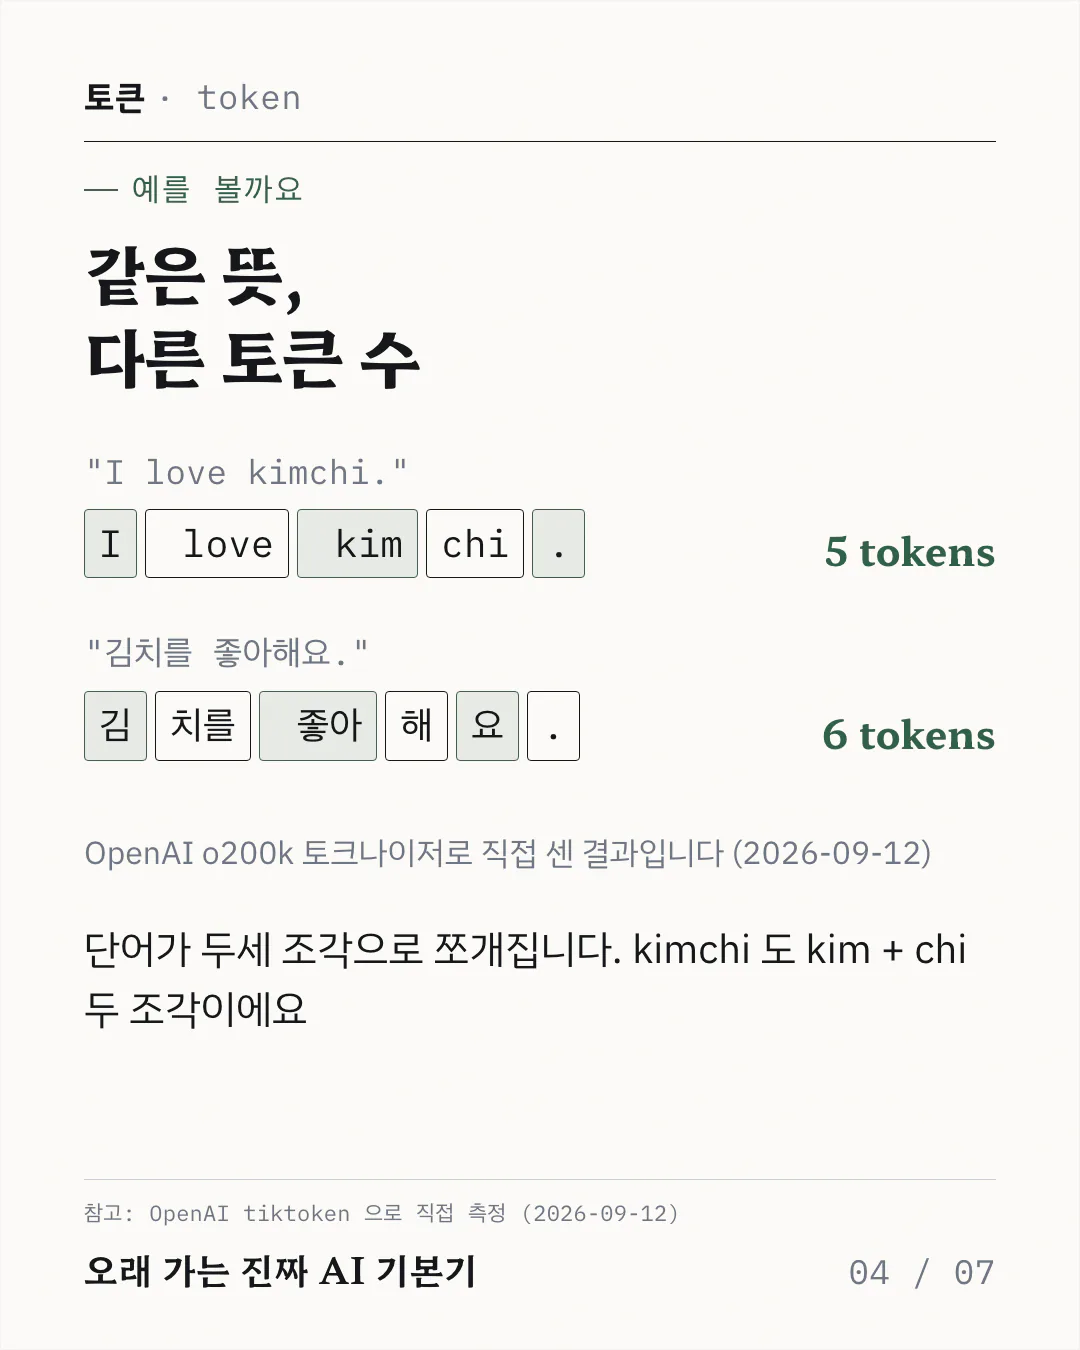
같은 뜻인데 토큰 수가 다른 이유
같은 한국어 문장을 구형 토크나이저(cl100k)로 세면 10조각이 나와요. 한글을 바이트 단위로 쪼개 버렸거든요. 신형(o200k)은 한국어를 더 배워서 6조각으로 줄었어요. 고정된 값이 아니에요.
카드 텍스트 보기
토큰 · token 예를 볼까요 같은 뜻, 다른 토큰 수 "I love kimchi." I love kim chi . 5 tokens "김치를 좋아해요." 김 치를 좋아 해 요 . 6 tokens OpenAI o200k 토크나이저로 직접 센 결과입니다 (2026-09-12) 단어가 두세 조각으로 쪼개집니다. kimchi 도 kim + chi 두 조각이에요 참고: OpenAI tiktoken 으로 직접 측정 (2026-09-12) 오래 가는 진짜 AI 기본기 04 / 07
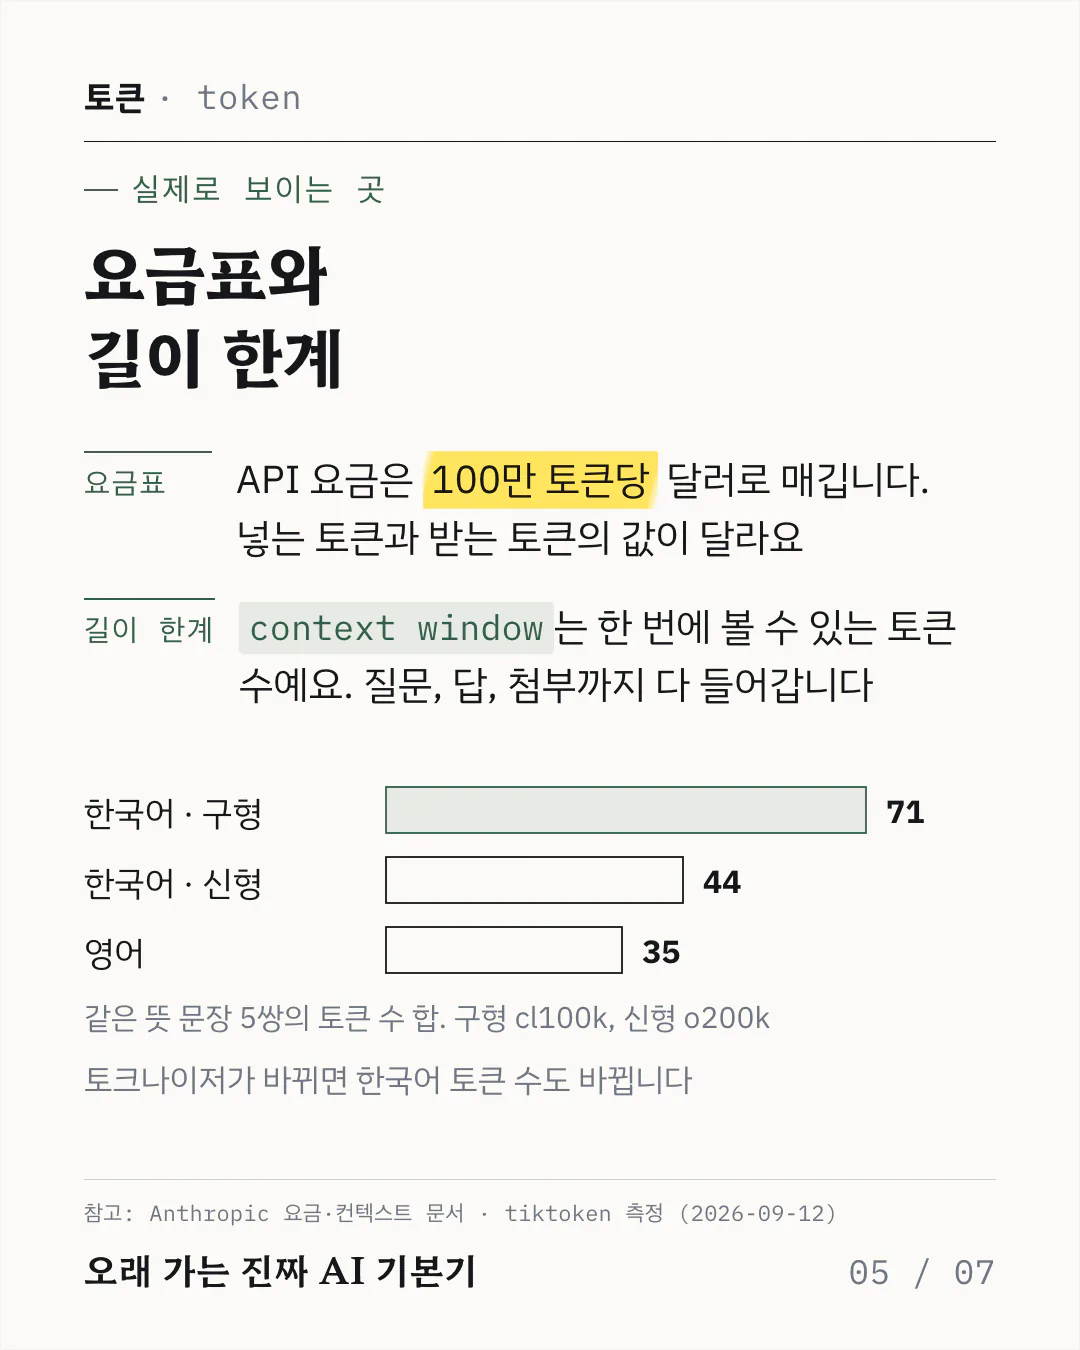
요금표와 컨텍스트 윈도우에서 만나는 토큰
요금표의 MTok 은 100만 토큰이라는 뜻이에요. 보통 넣는 토큰(입력)보다 받는 토큰(출력)이 몇 배 비싸요. 컨텍스트 윈도우는 모델마다 달라요. 2026년 9월 기준 클로드는 20만이나 100만까지 봐요.
카드 텍스트 보기
토큰 · token 실제로 보이는 곳 요금표와 길이 한계 요금표 API 요금은 100만 토큰당 달러로 매깁니다. 넣는 토큰과 받는 토큰의 값이 달라요 길이 한계 context window 는 한 번에 볼 수 있는 토큰 수예요. 질문, 답, 첨부까지 다 들어갑니다 한국어 · 구형 71 한국어 · 신형 44 영어 35 같은 뜻 문장 5쌍의 토큰 수 합. 구형 cl100k, 신형 o200k 토크나이저가 바뀌면 한국어 토큰 수도 바뀝니다 참고: Anthropic 요금·컨텍스트 문서 · tiktoken 측정 (2026-09-12) 오래 가는 진짜 AI 기본기 05 / 07
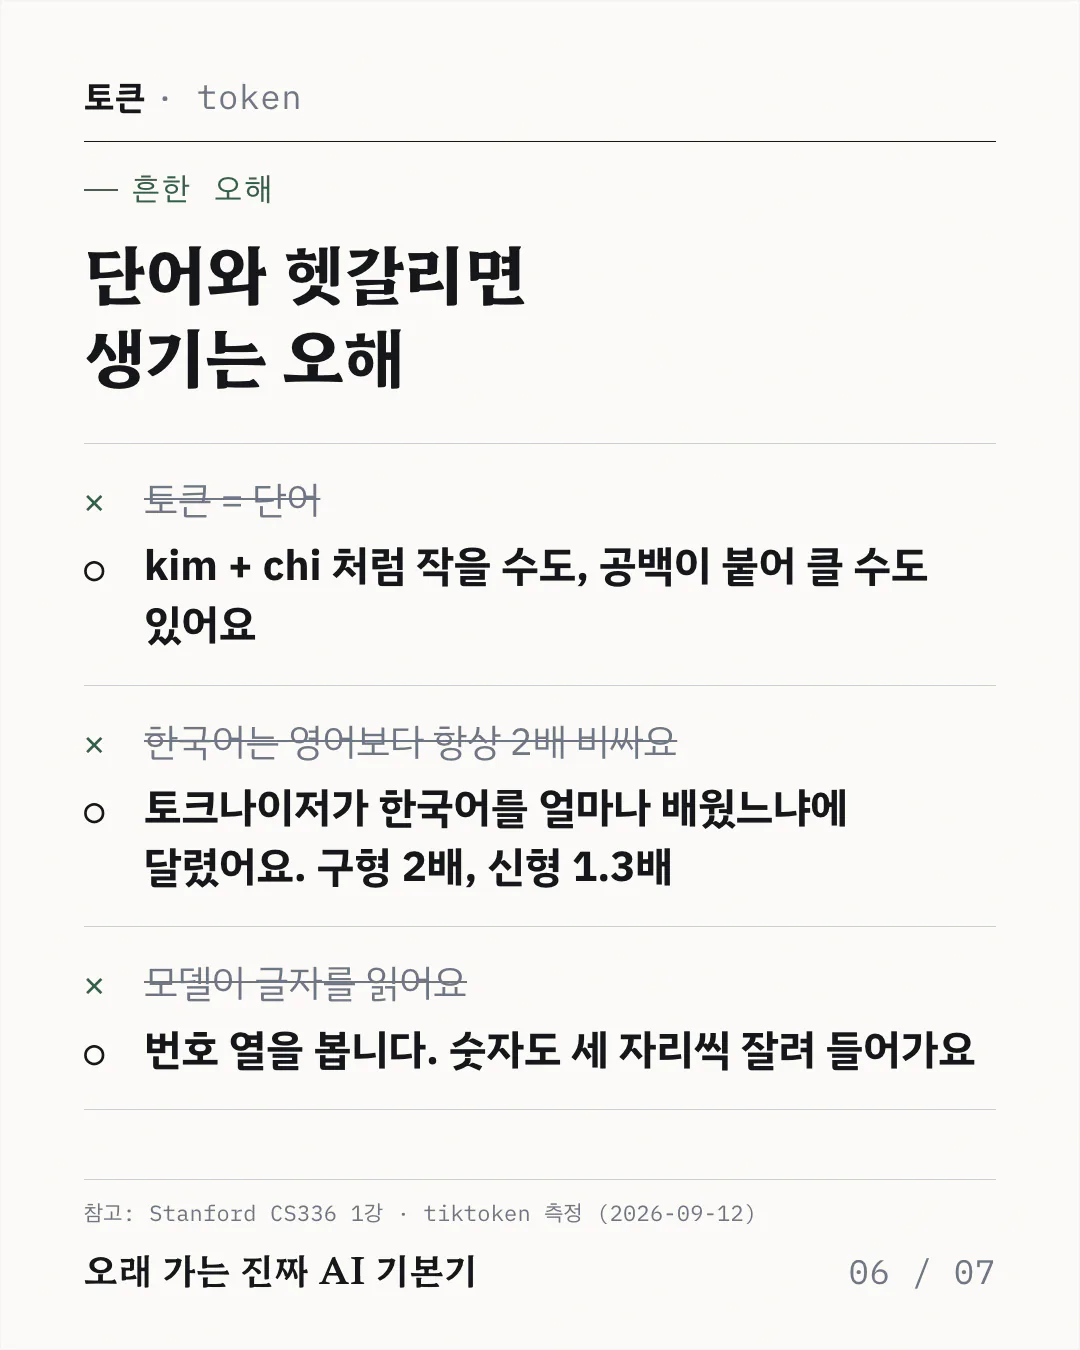
토큰을 단어로 착각하면 생기는 오해
숫자가 세 자리씩 잘려 들어간다는 건 직접 확인해 봤어요. 2026 은 202 와 6 으로 쪼개지더라고요. 모델이 산수에 약한 이유 중 하나가 여기 있죠.
카드 텍스트 보기
토큰 · token 흔한 오해 단어와 헷갈리면 생기는 오해 ✕ 토큰 = 단어 ○ kim + chi 처럼 작을 수도, 공백이 붙어 클 수도 있어요 ✕ 한국어는 영어보다 항상 2배 비싸요 ○ 토크나이저가 한국어를 얼마나 배웠느냐에 달렸어요. 구형 2배, 신형 1.3배 ✕ 모델이 글자를 읽어요 ○ 번호 열을 봅니다. 숫자도 세 자리씩 잘려 들어가요 참고: Stanford CS336 1강 · tiktoken 측정 (2026-09-12) 오래 가는 진짜 AI 기본기 06 / 07
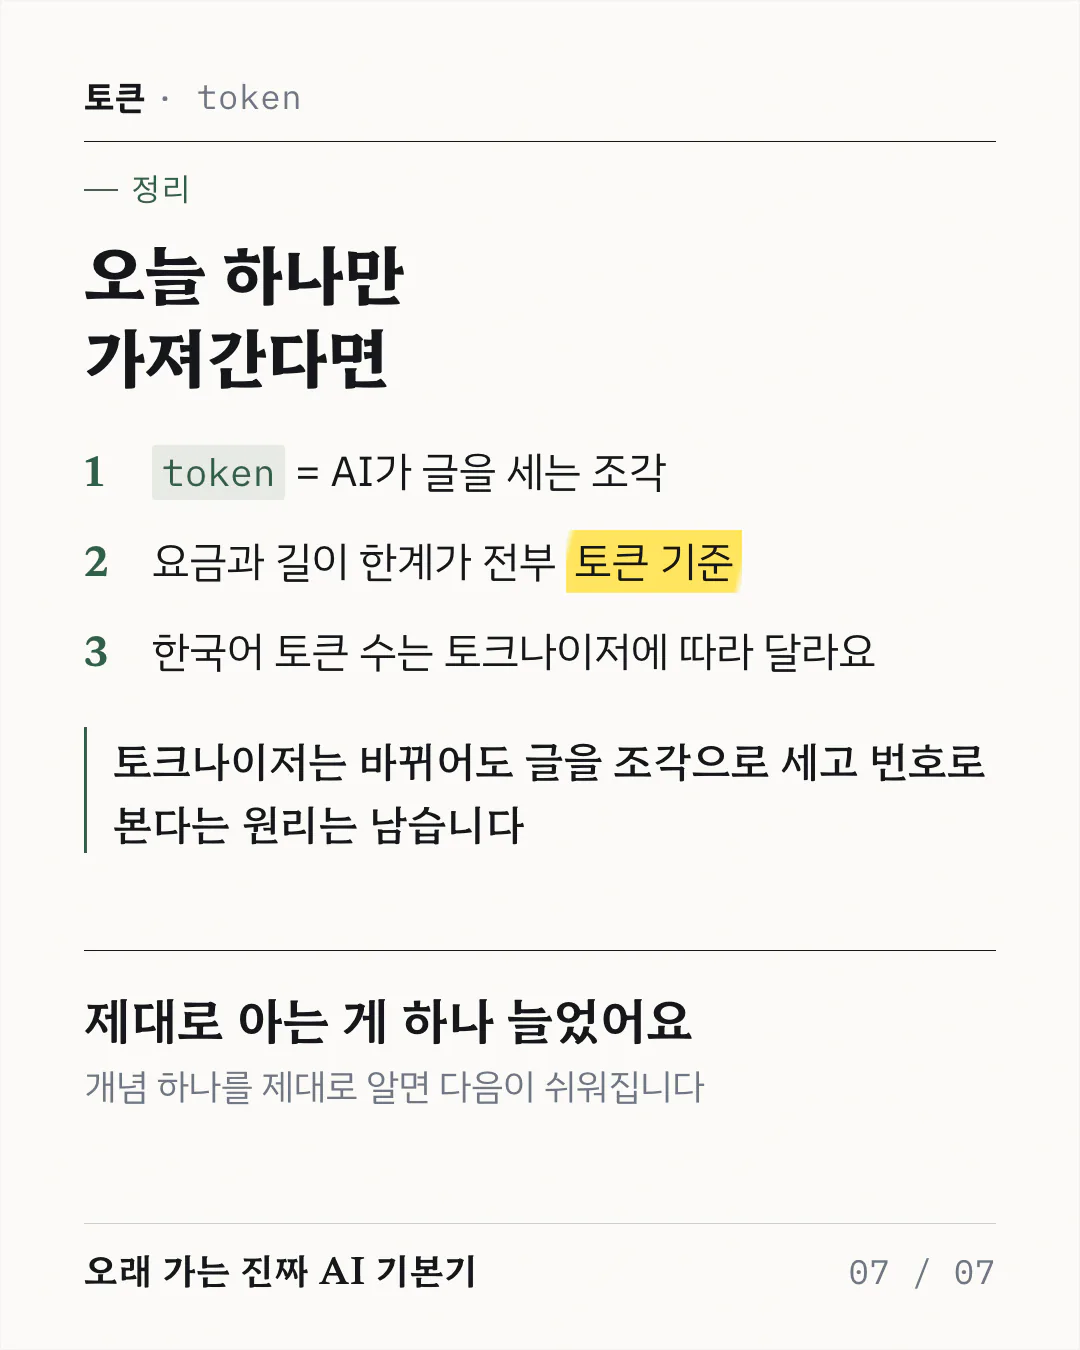
오늘 기억할 세 가지
요약 세 줄 중에서 세 번째가 실무에서 가장 자주 걸려요. 같은 글이라도 모델을 바꾸면 토큰 수가 달라지거든요. 비용을 잡을 때는 실제로 쓸 모델로 다시 세는 게 안전하죠.
카드 텍스트 보기
토큰 · token 정리 오늘 하나만 가져간다면 1 token = AI가 글을 세는 조각 2 요금과 길이 한계가 전부 토큰 기준 3 한국어 토큰 수는 토크나이저에 따라 달라요 토크나이저는 바뀌어도 글을 조각으로 세고 번호로 본다는 원리는 남습니다 제대로 아는 게 하나 늘었어요 개념 하나를 제대로 알면 다음이 쉬워집니다 오래 가는 진짜 AI 기본기 07 / 07
토큰이란 무엇일까
첫 개념으로 토큰을 고른 이유는 하나예요. 요금이든 길이 제한이든 응답 속도든 전부 이 단위로 따지거든요. 그런데 막상 그 단위가 뭔지는 잘 안 알려주죠.