학습과 추론: ChatGPT는 나와 대화하면서 배울까
카드 텍스트 보기
오래 가는 진짜 AI 기본기 알아야 보인다 training vs inference 학습과 추론 모델이 배우는 시간과 써먹는 시간 Q ChatGPT는 나와 대화하면서 배울까요? 01 / 07
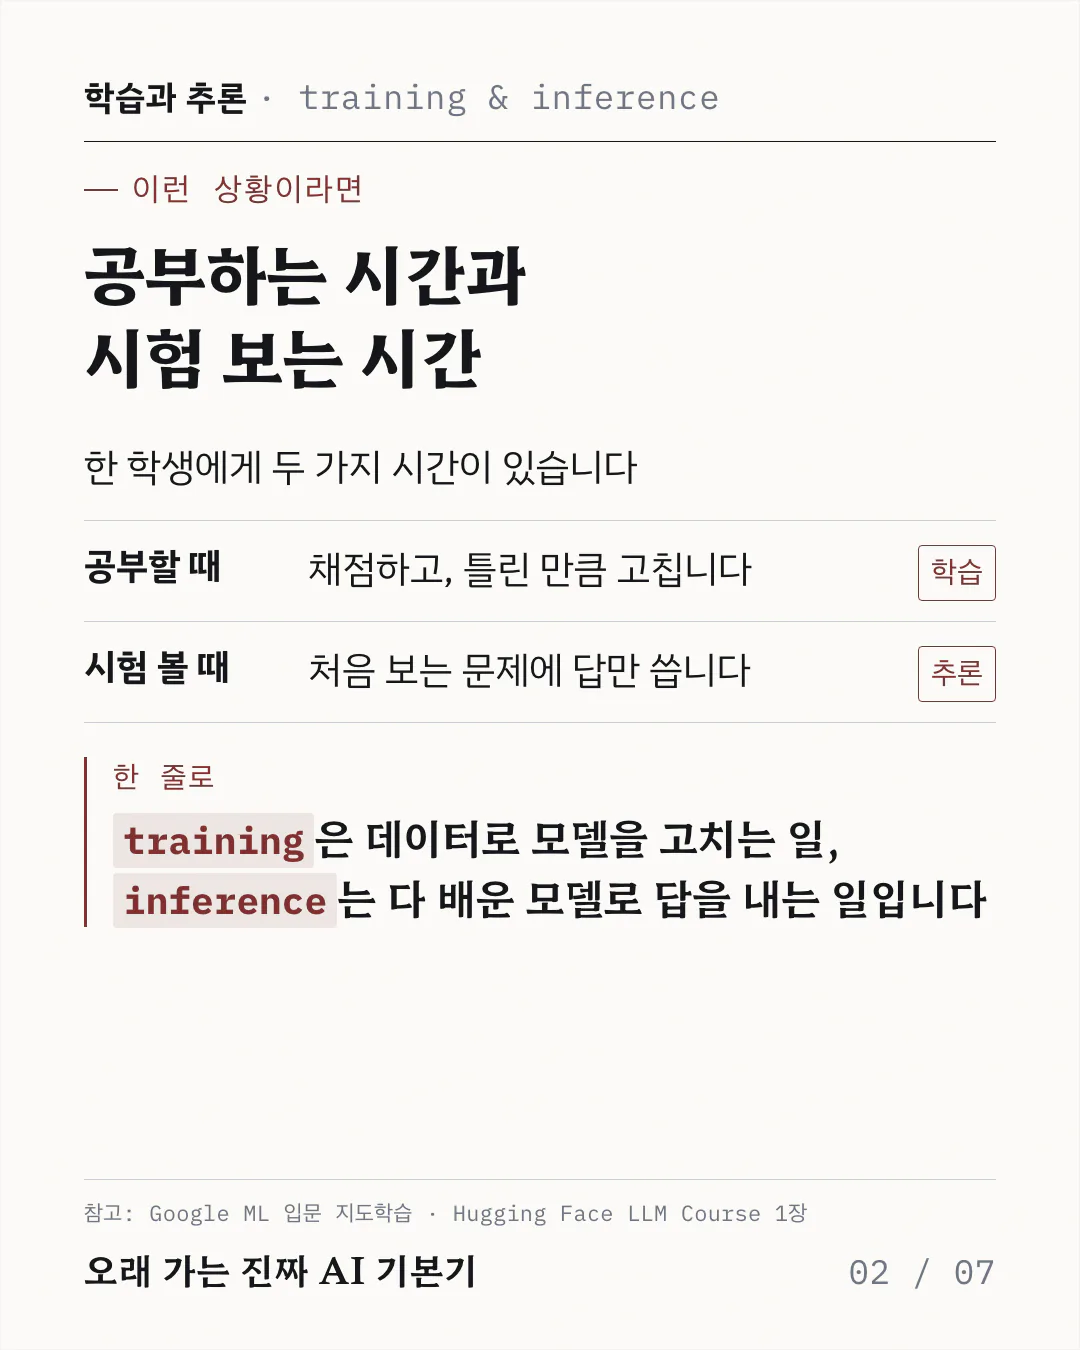
공부하는 시간과 시험 보는 시간
비유가 어긋나는 곳도 있어요. 사람은 시험을 치르면서도 조금씩 배우지만, 모델은 추론하는 동안 가중치가 그대로거든요. 배운 것이 반영되는 건 다음 학습 때예요.
카드 텍스트 보기
학습과 추론 · training & inference 이런 상황이라면 공부하는 시간과 시험 보는 시간 한 학생에게 두 가지 시간이 있습니다 공부할 때 채점하고, 틀린 만큼 고칩니다 학습 시험 볼 때 처음 보는 문제에 답만 씁니다 추론 한 줄로 training 은 데이터로 모델을 고치는 일, inference 는 다 배운 모델로 답을 내는 일입니다 참고: Google ML 입문 지도학습 · Hugging Face LLM Course 1장 오래 가는 진짜 AI 기본기 02 / 07
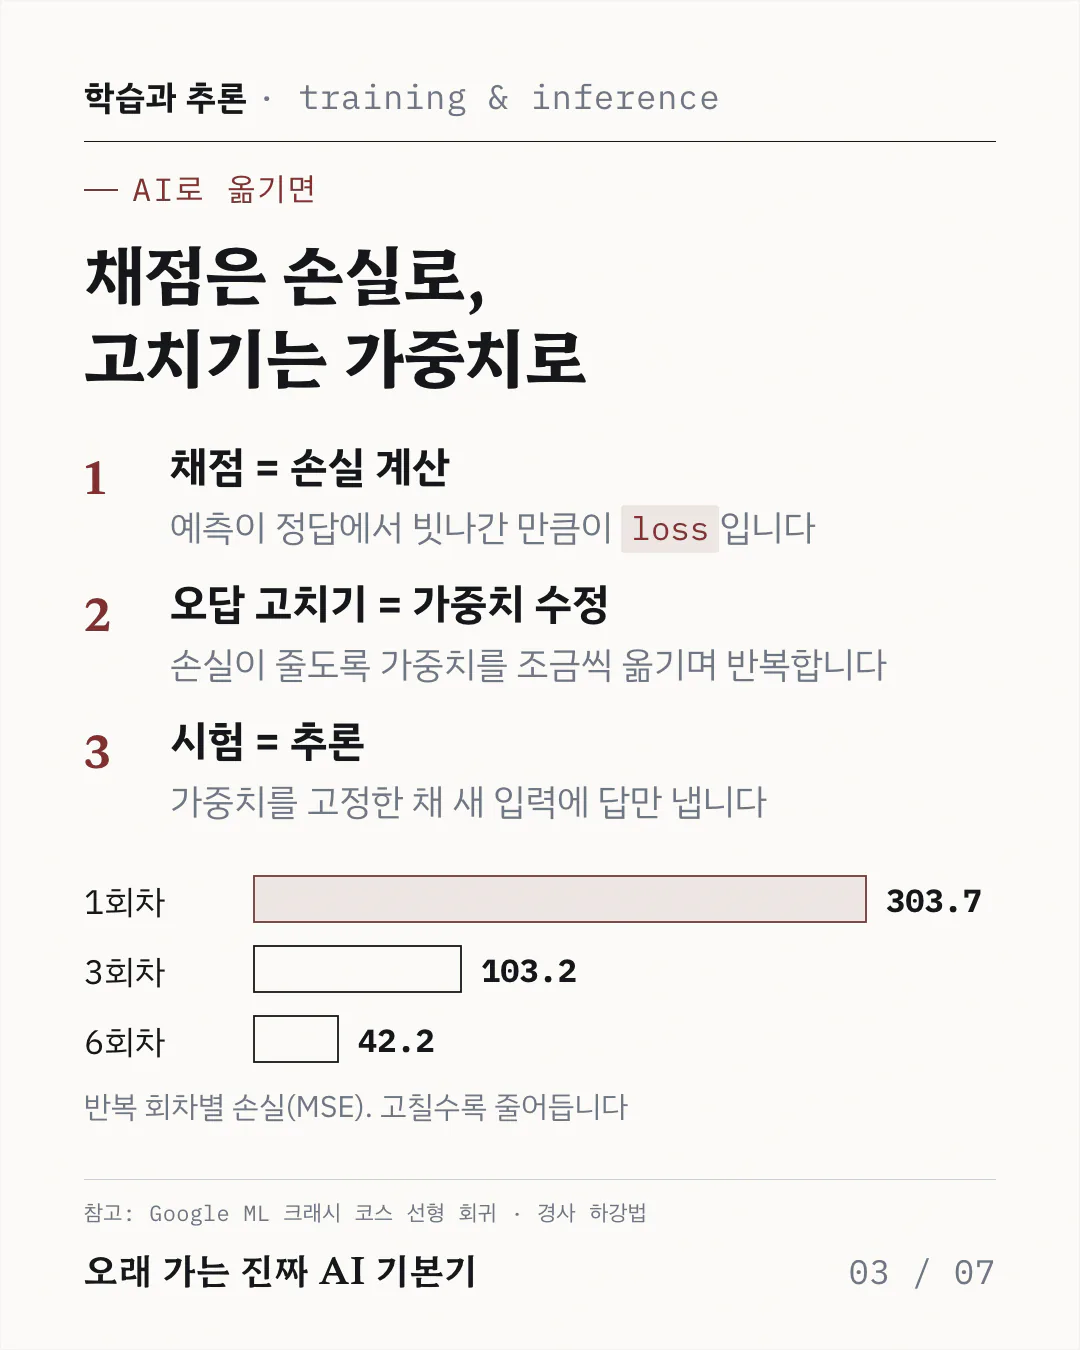
학습과 추론이 돌아가는 방식
이렇게 손실이 줄어드는 쪽으로 조금씩 내려가며 고치는 방법을 경사 하강법(gradient descent)이라고 불러요. 손실이 더 줄지 않을 때까지 이걸 반복하죠. 그 지점을 수렴(converge)이라고 해요.
카드 텍스트 보기
학습과 추론 · training & inference AI로 옮기면 채점은 손실로, 고치기는 가중치로 1 채점 = 손실 계산 예측이 정답에서 빗나간 만큼이 loss 입니다 2 오답 고치기 = 가중치 수정 손실이 줄도록 가중치를 조금씩 옮기며 반복합니다 3 시험 = 추론 가중치를 고정한 채 새 입력에 답만 냅니다 1회차 303.7 3회차 103.2 6회차 42.2 반복 회차별 손실(MSE). 고칠수록 줄어듭니다 참고: Google ML 크래시 코스 선형 회귀 · 경사 하강법 오래 가는 진짜 AI 기본기 03 / 07
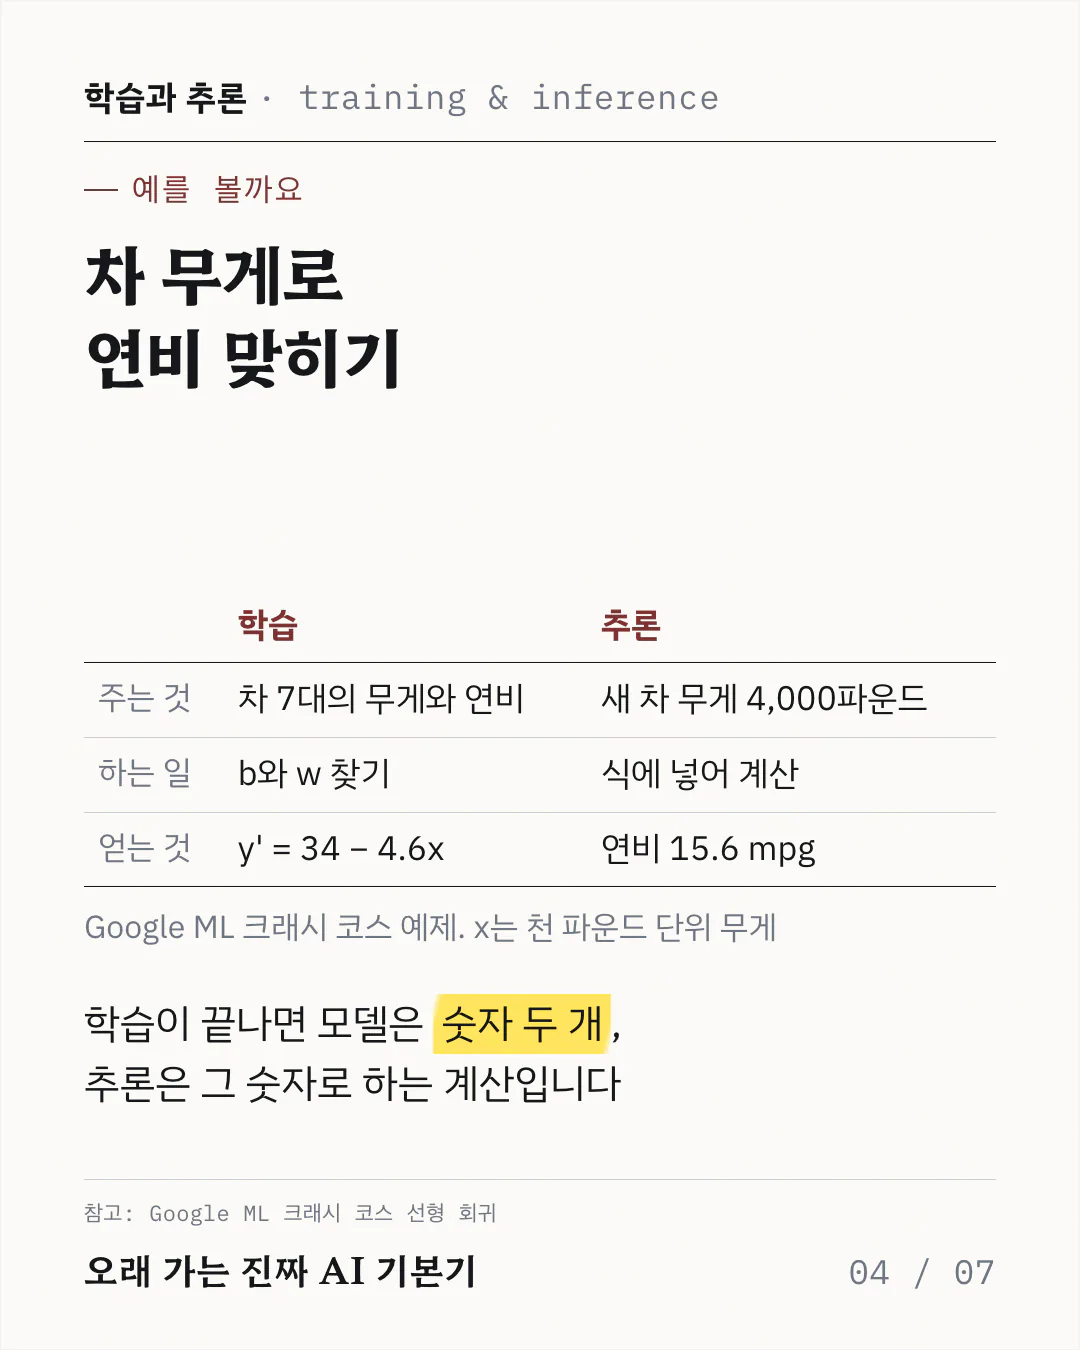
숫자 두 개로 끝나는 모델
LLM 도 원리는 같아요. 숫자가 수십억 개일 뿐이죠. Karpathy 강의를 보면 2023년 공개 모델 하나를 학습하는 데 GPU 약 6,000개로 12일쯤 걸렸는데, 추론은 노트북 한 대로도 돌아가요.
카드 텍스트 보기
학습과 추론 · training & inference 예를 볼까요 차 무게로 연비 맞히기 학습 추론 주는 것 차 7대의 무게와 연비 새 차 무게 4,000파운드 하는 일 b와 w 찾기 식에 넣어 계산 얻는 것 y' = 34 − 4.6x 연비 15.6 mpg Google ML 크래시 코스 예제. x는 천 파운드 단위 무게 학습이 끝나면 모델은 숫자 두 개 , 추론은 그 숫자로 하는 계산입니다 참고: Google ML 크래시 코스 선형 회귀 오래 가는 진짜 AI 기본기 04 / 07
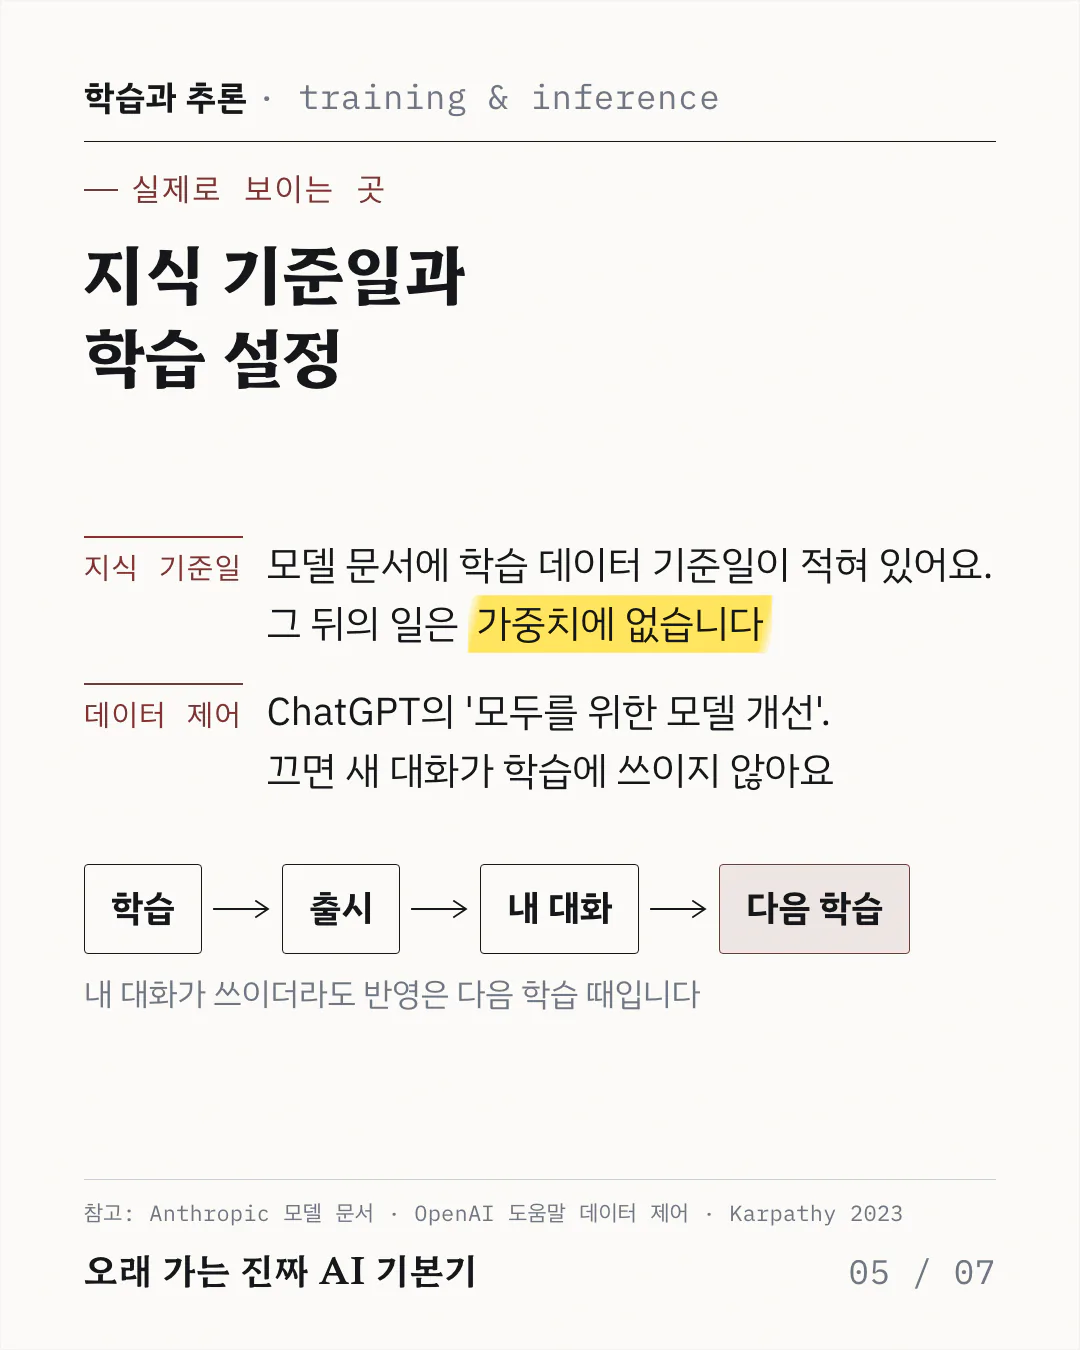
지식 기준일과 학습 설정에서 만나는 구분
API 로 보낸 데이터는 기본적으로 학습에 안 쓰여요. OpenAI 문서가 2023년 3월 1일부터 그렇다고 밝히고 있죠. 기준일 뒤의 일을 답할 때는 검색 결과를 대화에 붙여 넣고 읽는 거예요.
카드 텍스트 보기
학습과 추론 · training & inference 실제로 보이는 곳 지식 기준일과 학습 설정 지식 기준일 모델 문서에 학습 데이터 기준일이 적혀 있어요. 그 뒤의 일은 가중치에 없습니다 데이터 제어 ChatGPT의 '모두를 위한 모델 개선'. 끄면 새 대화가 학습에 쓰이지 않아요 학습 출시 내 대화 다음 학습 내 대화가 쓰이더라도 반영은 다음 학습 때입니다 참고: Anthropic 모델 문서 · OpenAI 도움말 데이터 제어 · Karpathy 2023 오래 가는 진짜 AI 기본기 05 / 07
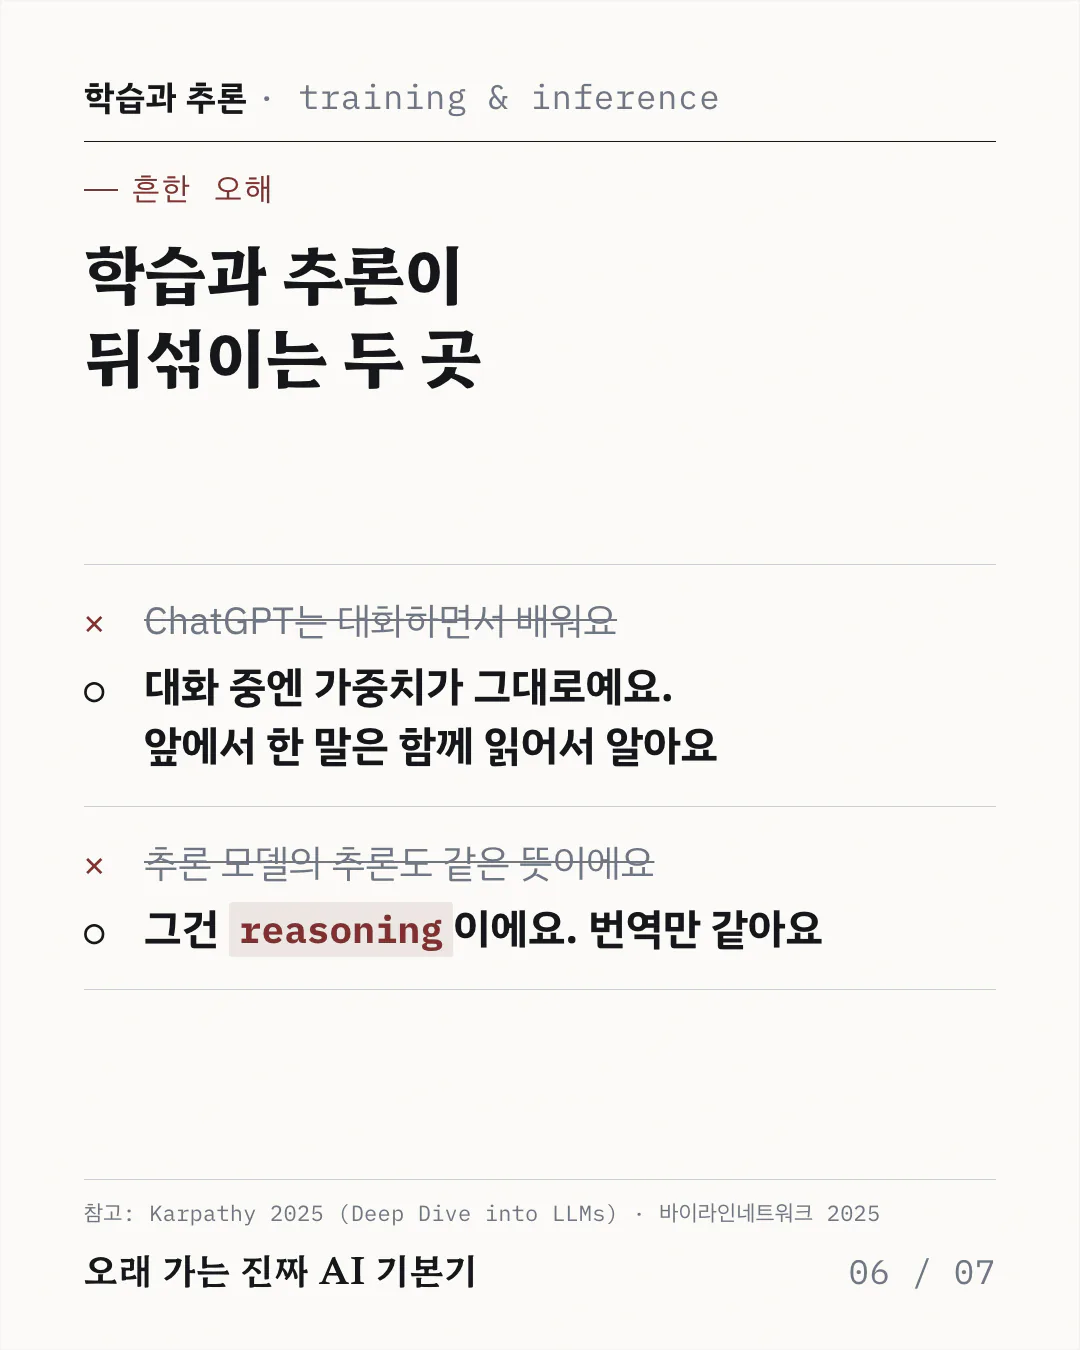
학습과 추론을 헷갈리는 두 장면
메모리 기능도 학습은 아니에요. OpenAI 도움말은 메모리와 모델 학습을 서로 다른 설정이라고 적어 뒀거든요. 메모리를 꺼도 학습 설정은 그대로고, 그 반대도 마찬가지죠.
카드 텍스트 보기
학습과 추론 · training & inference 흔한 오해 학습과 추론이 뒤섞이는 두 곳 ✕ ChatGPT는 대화하면서 배워요 ○ 대화 중엔 가중치가 그대로예요. 앞에서 한 말은 함께 읽어서 알아요 ✕ 추론 모델의 추론도 같은 뜻이에요 ○ 그건 reasoning 이에요. 번역만 같아요 참고: Karpathy 2025 (Deep Dive into LLMs) · 바이라인네트워크 2025 오래 가는 진짜 AI 기본기 06 / 07
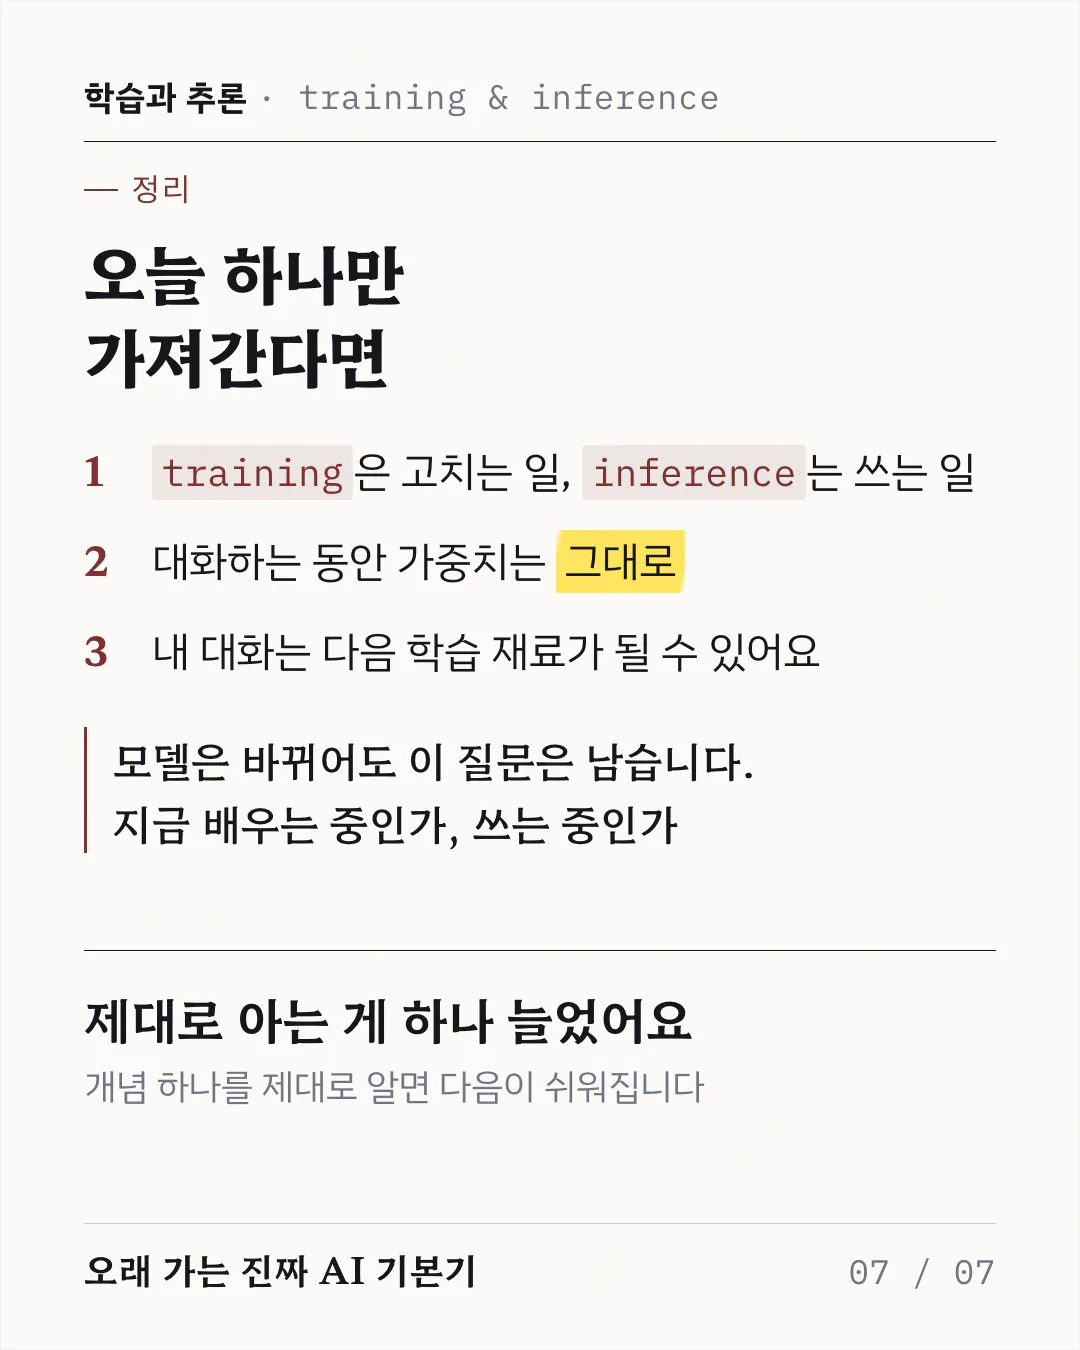
오늘 기억할 세 가지
요약 두 번째 줄이 실무에서 제일 쓸모 있어요. 대화로 아무리 가르쳐도 모델 자체는 그대로거든요. 꼭 필요한 내용은 그때그때 대화에 넣어 주는 게 확실하죠.
카드 텍스트 보기
학습과 추론 · training & inference 정리 오늘 하나만 가져간다면 1 training 은 고치는 일, inference 는 쓰는 일 2 대화하는 동안 가중치는 그대로 3 내 대화는 다음 학습 재료가 될 수 있어요 모델은 바뀌어도 이 질문은 남습니다. 지금 배우는 중인가, 쓰는 중인가 제대로 아는 게 하나 늘었어요 개념 하나를 제대로 알면 다음이 쉬워집니다 오래 가는 진짜 AI 기본기 07 / 07
출처
- Google 머신러닝 입문 Supervised Learning (Training · Inference)
- Google 머신러닝 크래시 코스 선형 회귀
- Google 머신러닝 크래시 코스 손실
- Google 머신러닝 크래시 코스 경사 하강법
- Hugging Face LLM Course 1장 4절 How do Transformers work?
- Hugging Face LLM Course 1장 8절 Inference with LLMs
- Andrej Karpathy, Deep Dive into LLMs like ChatGPT (2025)
- Andrej Karpathy, Intro to Large Language Models (2023)
- Anthropic 문서 Models overview
- OpenAI 도움말 데이터 제어 FAQ
- OpenAI 문서 Your data
- 바이라인네트워크, [그게 뭔가요] 생성형 AI에서 '추론'이란 (2025)
학습과 추론이란 무엇일까
학습과 추론은 같은 모델이 서로 다른 때에 하는 일이에요. 둘을 갈라 두면 '내 대화가 AI 학습에 쓰이나' 같은 질문도 훨씬 또렷하게 물을 수 있죠.