임베딩: AI는 단어가 달라도 뜻이 비슷한 글을 어떻게 찾을까
카드 텍스트 보기
오래 가는 진짜 AI 기본기 알아야 보인다 embedding 임베딩 비슷한 것끼리 가까운 자리에 놓는 숫자 목록 Q AI는 단어가 달라도 뜻이 비슷한 글을 어떻게 찾을까요? 01 / 07
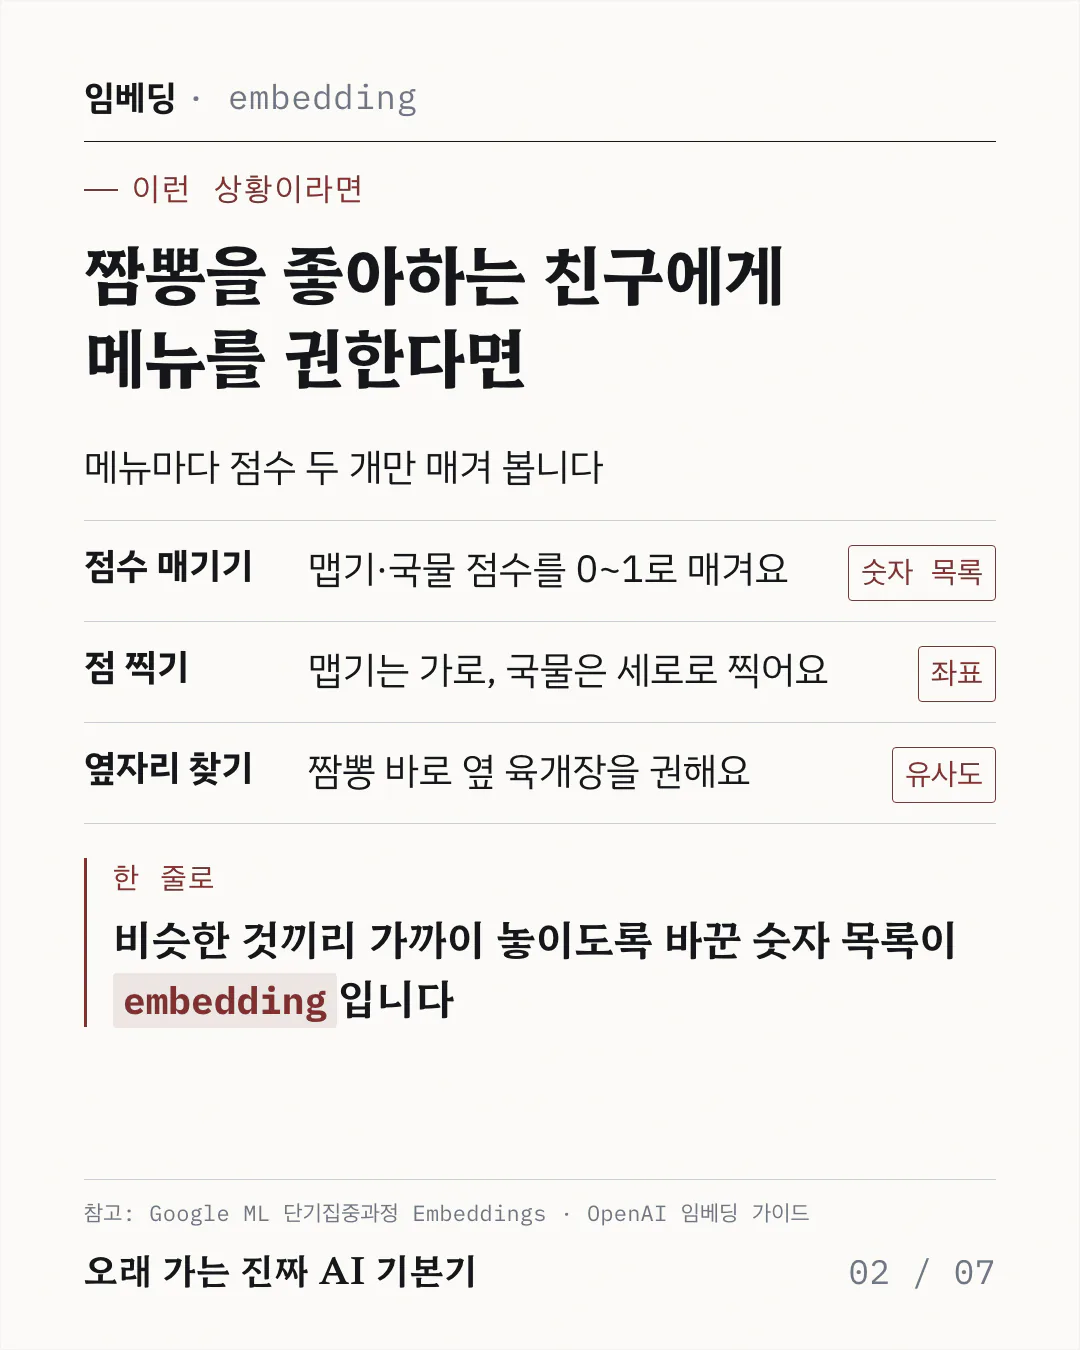
점수 두 개로 비슷한 메뉴 찾기
메뉴 점수는 Google 머신러닝 강좌의 음식 예를 빌렸다. 비유가 어긋나는 곳도 있다. 메뉴 점수는 사람이 매긴다. 임베딩의 점수는 모델이 학습으로 정한다. 축도 두 개가 아니라 수백 개다.
카드 텍스트 보기
임베딩 · embedding 이런 상황이라면 짬뽕을 좋아하는 친구에게 메뉴를 권한다면 메뉴마다 점수 두 개만 매겨 봅니다 점수 매기기 맵기·국물 점수를 0~1로 매겨요 숫자 목록 점 찍기 맵기는 가로, 국물은 세로로 찍어요 좌표 옆자리 찾기 짬뽕 바로 옆 육개장을 권해요 유사도 한 줄로 비슷한 것끼리 가까이 놓이도록 바꾼 숫자 목록이 embedding 입니다 참고: Google ML 단기집중과정 Embeddings · OpenAI 임베딩 가이드 오래 가는 진짜 AI 기본기 02 / 07
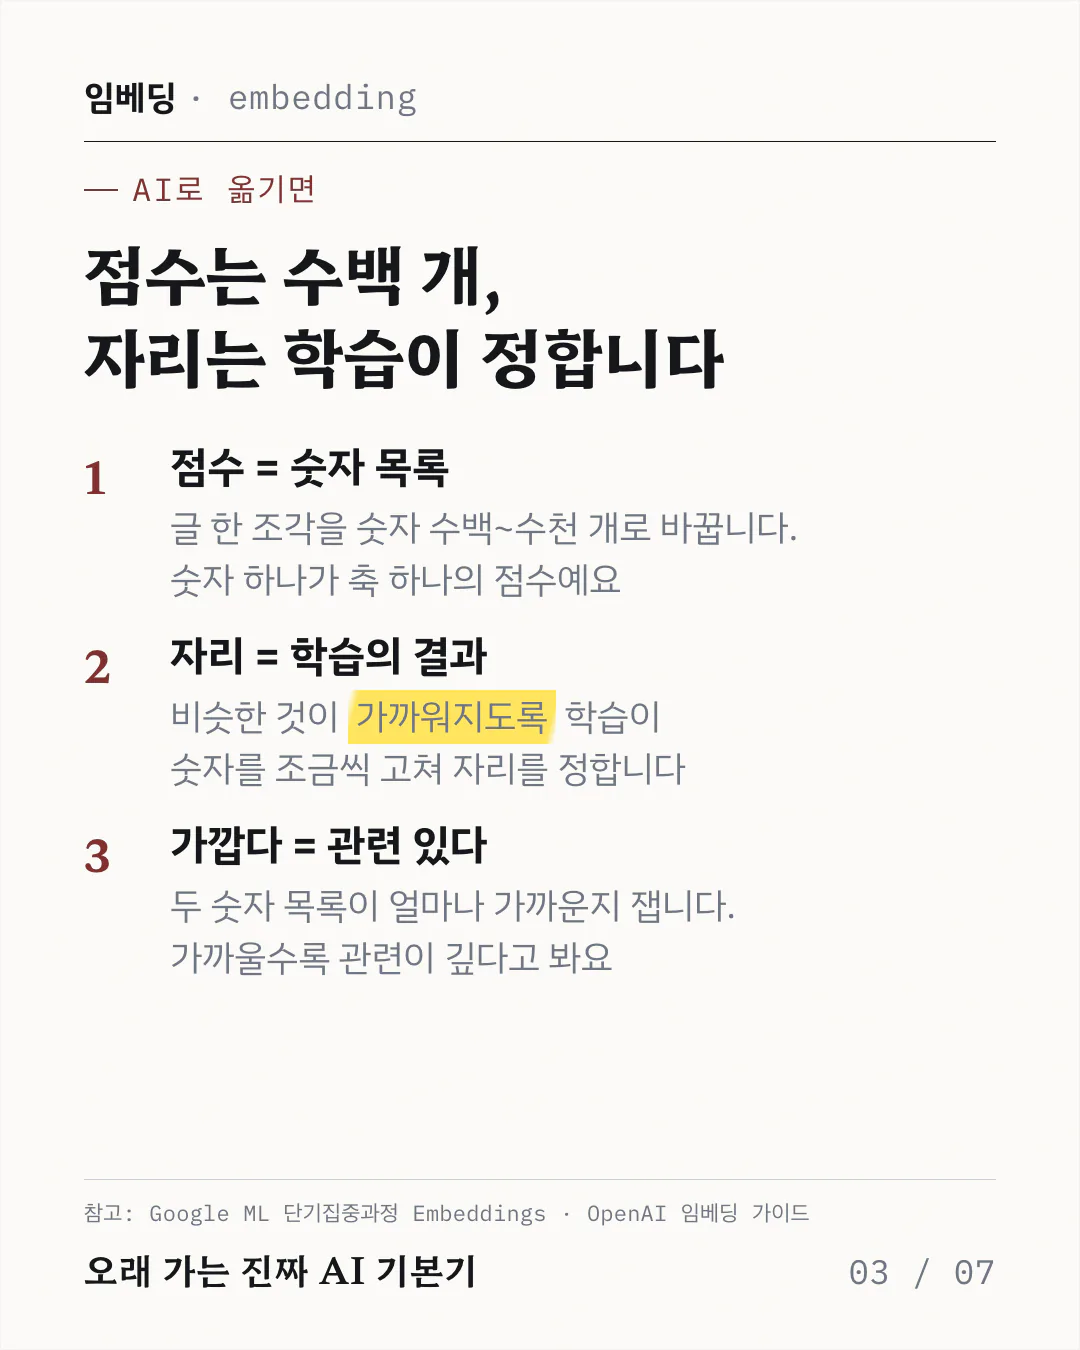
숫자 목록이 되고, 자리를 잡고, 거리를 잰다
가까운 정도는 보통 코사인 유사도로 잰다. 두 숫자 목록이 같은 쪽을 가리킬수록 1에 가까워진다. OpenAI 는 이 방법을 권한다. 어떤 방법을 쓰든 결과는 크게 다르지 않다고도 적었다.
카드 텍스트 보기
임베딩 · embedding AI로 옮기면 점수는 수백 개, 자리는 학습이 정합니다 1 점수 = 숫자 목록 글 한 조각을 숫자 수백~수천 개로 바꿉니다. 숫자 하나가 축 하나의 점수예요 2 자리 = 학습의 결과 비슷한 것이 가까워지도록 학습이 숫자를 조금씩 고쳐 자리를 정합니다 3 가깝다 = 관련 있다 두 숫자 목록이 얼마나 가까운지 잽니다. 가까울수록 관련이 깊다고 봐요 참고: Google ML 단기집중과정 Embeddings · OpenAI 임베딩 가이드 오래 가는 진짜 AI 기본기 03 / 07
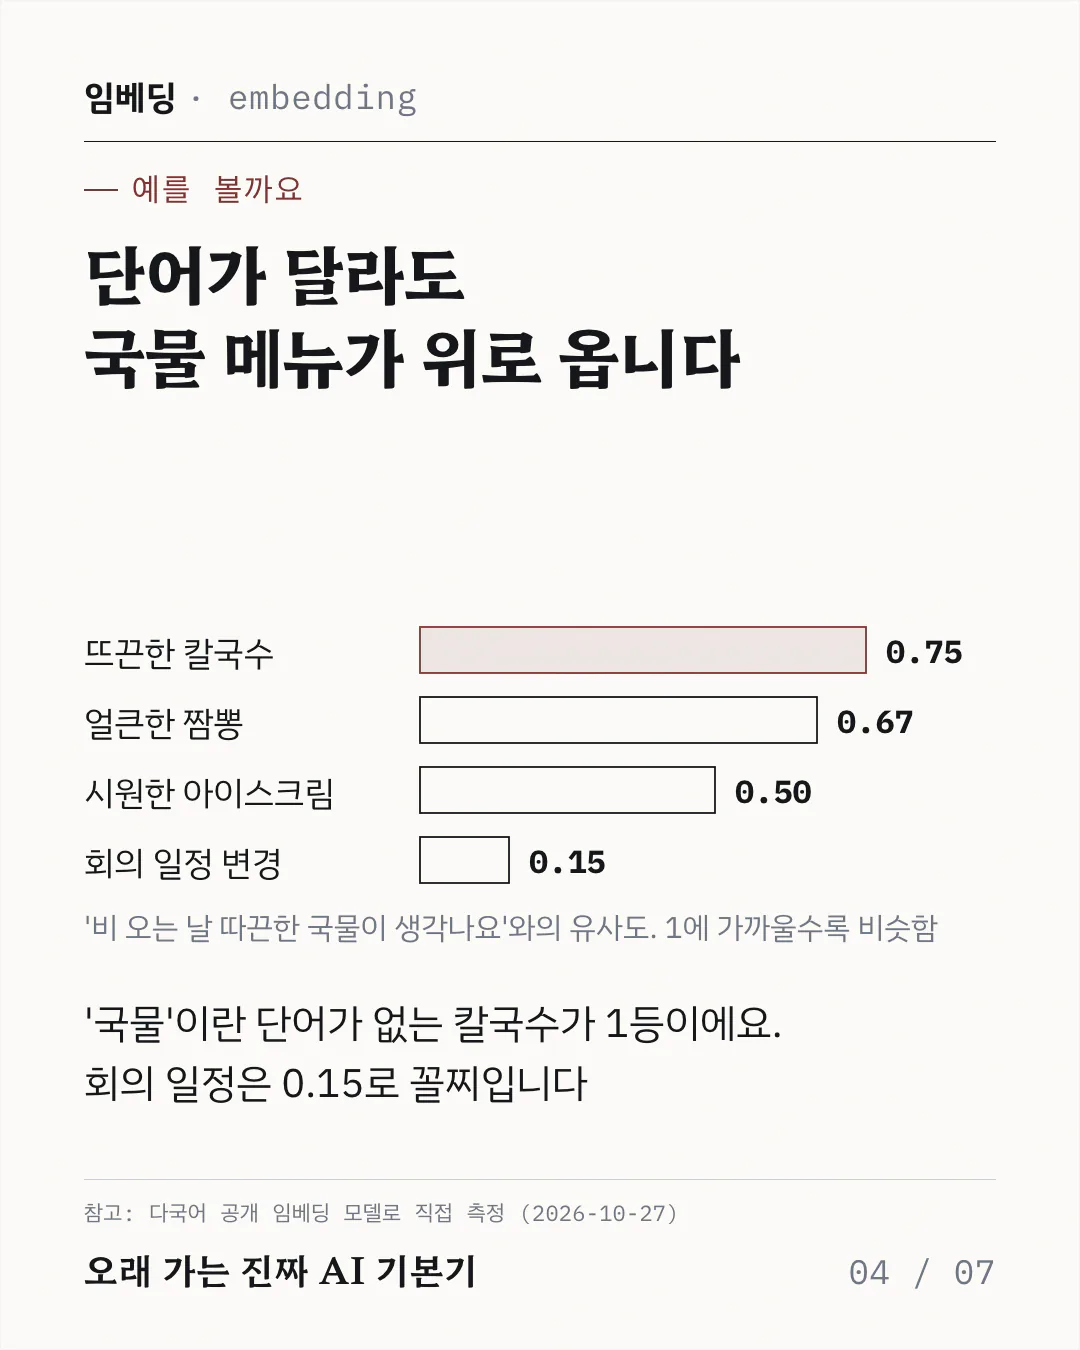
국물이 당길 때 가장 가까운 메뉴
더 작은 모델로도 재 보았다. 그 모델은 '배가 고파요'와 '오늘 날씨 어때요'를 0.97로 거의 붙여 놓았다. 같은 문장도 모델마다 자리가 다르다. 모델을 바꾸면 검색 결과도 달라질 수 있다.
카드 텍스트 보기
임베딩 · embedding 예를 볼까요 단어가 달라도 국물 메뉴가 위로 옵니다 뜨끈한 칼국수 0.75 얼큰한 짬뽕 0.67 시원한 아이스크림 0.50 회의 일정 변경 0.15 '비 오는 날 따끈한 국물이 생각나요'와의 유사도. 1에 가까울수록 비슷함 '국물'이란 단어가 없는 칼국수가 1등이에요. 회의 일정은 0.15로 꼴찌입니다 참고: 다국어 공개 임베딩 모델로 직접 측정 (2026-10-27) 오래 가는 진짜 AI 기본기 04 / 07
ChatGPT 안쪽과 검색창 뒤편의 임베딩
이 숫자 목록도 학습으로 채우는 파라미터다. GPT-3 는 토큰 50,257개에 숫자 12,288개씩을 붙인다. 첫 단계의 이 표에만 가중치가 6억 개가 넘는다.
카드 텍스트 보기
임베딩 · embedding 실제로 보이는 곳 ChatGPT 안쪽과 검색창 뒤편 ChatGPT GPT 모델은 글을 쪼갠 token 마다 숫자 목록을 붙이며 시작해요. GPT-3는 토큰 하나에 숫자 12,288개 검색·추천 질문과 글을 둘 다 숫자 목록으로 바꿔 거리를 잽니다. 단어가 안 겹쳐도 가까운 글을 찾아요 참고: 3Blue1Brown (But what is a GPT?) · OpenAI 임베딩 가이드 오래 가는 진짜 AI 기본기 05 / 07
숫자 목록을 두고 생기는 오해
같은 단어도 문장마다 자리가 바뀐다. fashion model 과 machine learning model 의 model 은 뜻이 다르다. 트랜스포머는 앞뒤 단어를 읽으며 숫자를 고친다. 문맥 임베딩이라고 부른다.
카드 텍스트 보기
임베딩 · embedding 흔한 오해 숫자 목록을 두고 생기는 오해 ✕ 숫자마다 '맵기' 같은 뜻이 있어요 ○ 보통은 사람이 이름을 붙이기 어려워요. 숫자 전체를 한꺼번에 견줘 비슷함을 봅니다 ✕ 가까우면 뜻이 같아요 ○ '배가 고파요'와 가장 가까운 건 '점심 뭐 먹지'가 아닌 '배가 아파요'였어요 참고: Google ML 단기집중과정 · Google ML 용어집 · 직접 측정 오래 가는 진짜 AI 기본기 06 / 07
오늘 기억할 세 가지
검색이 엉뚱한 글을 가져오면 거리를 의심해 보면 된다. 질문과 비슷하게 쓰인 글이 꼭 답을 담고 있지는 않다. 임베딩이 재는 것은 관련 정도까지다.
카드 텍스트 보기
임베딩 · embedding 정리 오늘 하나만 가져간다면 1 embedding = 비슷한 것끼리 가까운 숫자 목록 2 얼마나 가까운지 재면 관련 정도 가 나와요 3 가깝다는 건 비슷하다는 것, 같은 뜻은 아니에요 모델은 바뀌어도 뜻을 거리로 재는 방식은 남습니다 제대로 아는 게 하나 늘었어요 개념 하나를 제대로 알면 다음이 쉬워집니다 오래 가는 진짜 AI 기본기 07 / 07
출처
- Google 머신러닝 단기집중과정, Embeddings
- Google 머신러닝 단기집중과정, Embedding space and static embeddings
- Google 머신러닝 단기집중과정, Obtaining embeddings
- Google 머신러닝 용어집
- OpenAI, Vector embeddings 가이드
- 3Blue1Brown, But what is a GPT?
- sentence-transformers, paraphrase-multilingual-mpnet-base-v2
- Qdrant, fastembed
유사도는 paraphrase-multilingual-mpnet-base-v2 모델을 fastembed 0.9.1 로 돌려 2026-10-27 에 직접 재 보았다. 후보 문장은 예시로 직접 썼다.
임베딩이란 무엇일까
검색과 추천, ChatGPT 안쪽에 같은 원리가 깔려 있다. 뜻을 거리로 바꾸는 일이다. 이 그림을 알면 AI 검색이 가끔 엉뚱한 글을 가져오는 이유도 짐작이 간다.