파라미터: 7B 모델의 7B는 무엇을 센 숫자일까
카드 텍스트 보기
오래 가는 진짜 AI 기본기 알아야 보인다 parameters · weights 파라미터 모델 안에서 학습이 정하는 숫자들 Q 7B 모델의 7B는 무엇을 센 숫자일까요? 01 / 07
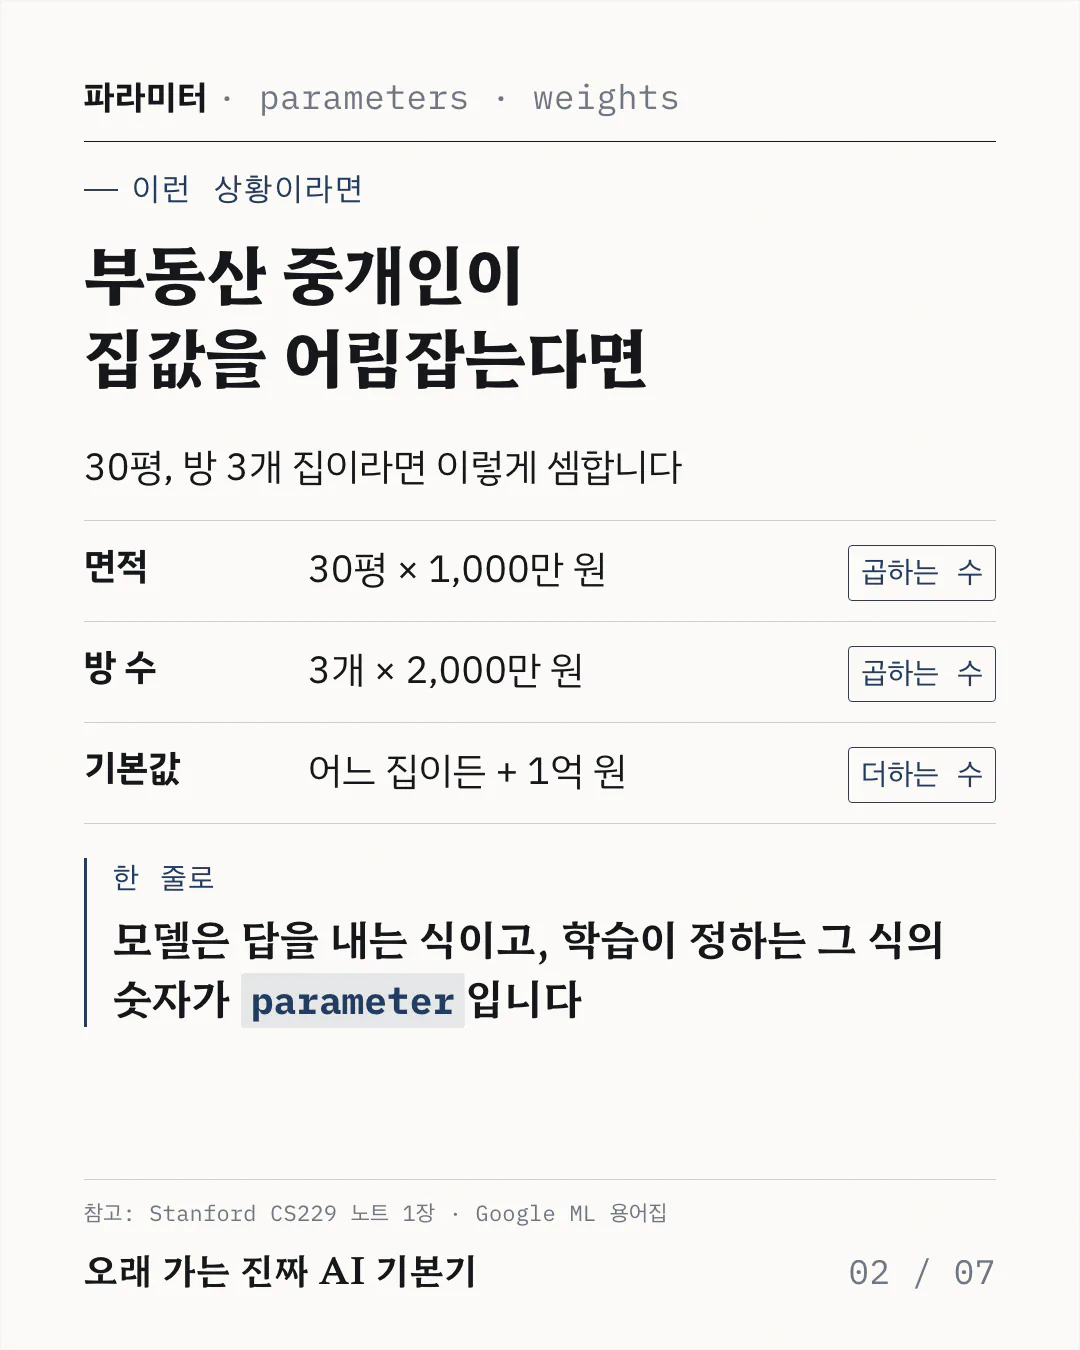
집값을 매기는 세 가지 숫자
셋을 더하면 3억 + 6천만 + 1억, 4억 6천만 원이에요. 이 셈법은 스탠퍼드 CS229 강의 노트의 첫 예제와 같거든요. 다른 점은 하나예요. 중개인은 경험으로 숫자를 고르지만 모델은 데이터로 찾죠.
카드 텍스트 보기
파라미터 · parameters · weights 이런 상황이라면 부동산 중개인이 집값을 어림잡는다면 30평, 방 3개 집이라면 이렇게 셈합니다 면적 30평 × 1,000만 원 곱하는 수 방 수 3개 × 2,000만 원 곱하는 수 기본값 어느 집이든 + 1억 원 더하는 수 한 줄로 모델은 답을 내는 식이고, 학습이 정하는 그 식의 숫자가 parameter 입니다 참고: Stanford CS229 노트 1장 · Google ML 용어집 오래 가는 진짜 AI 기본기 02 / 07
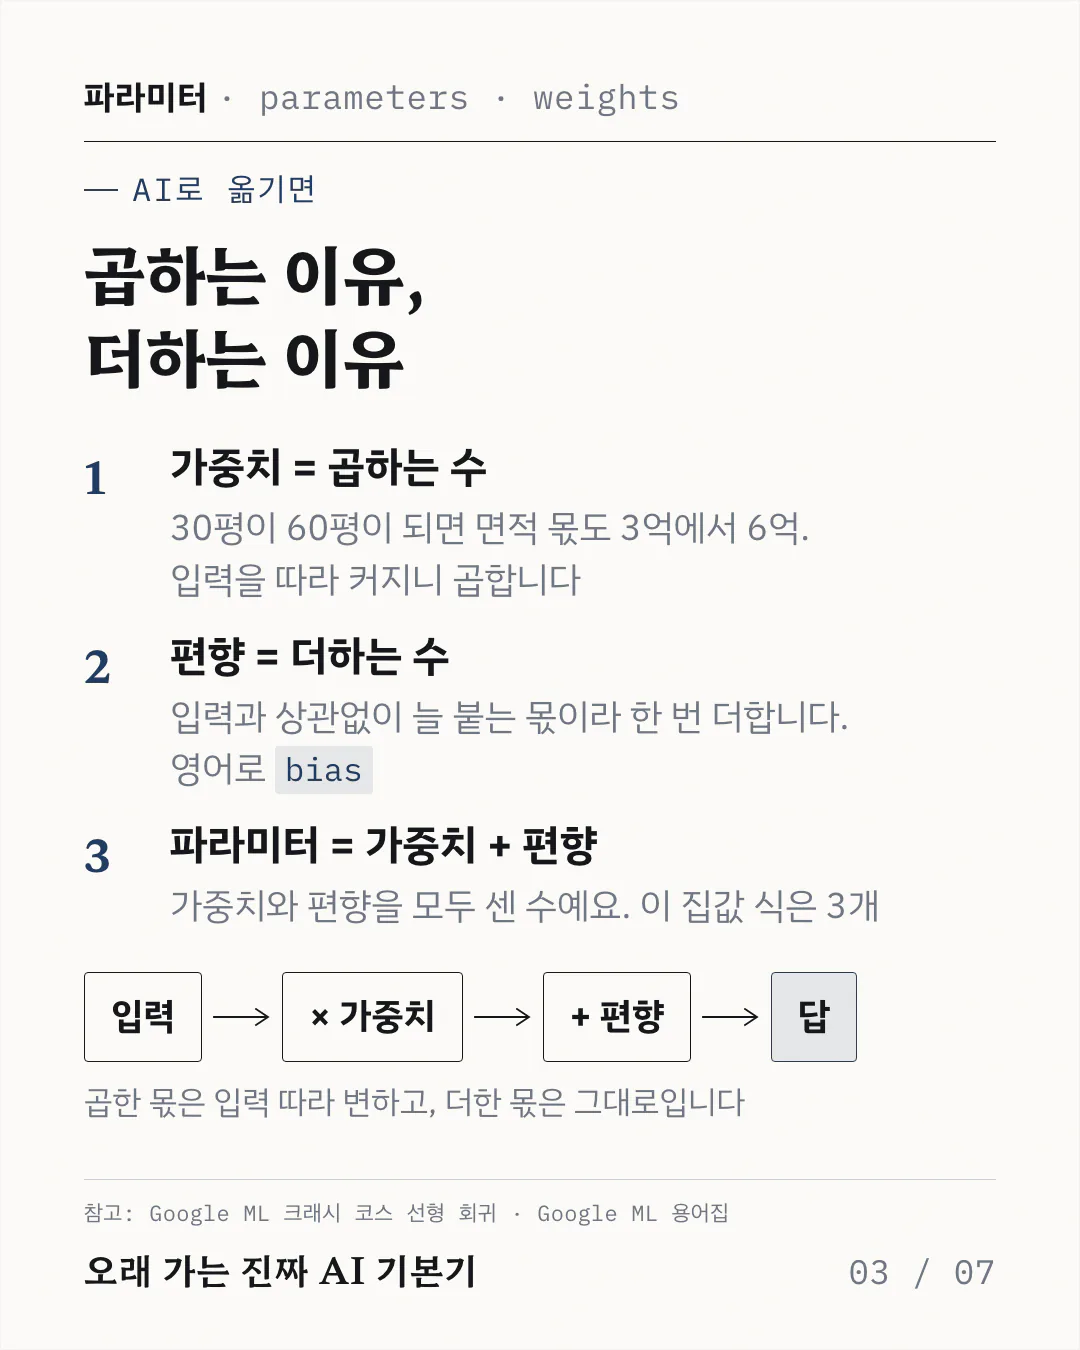
곱하는 이유와 더하는 이유
숫자를 찾는 건 학습이 하는 일이에요. 아무 값에서 시작해서 예측과 실제 집값의 차이가 줄도록 조금씩 고치거든요. 가중치는 음수도 돼요. 역에서 멀수록 값이 떨어진다면 그 거리의 가중치는 음수죠.
카드 텍스트 보기
파라미터 · parameters · weights AI로 옮기면 곱하는 이유, 더하는 이유 1 가중치 = 곱하는 수 30평이 60평이 되면 면적 몫도 3억에서 6억. 입력을 따라 커지니 곱합니다 2 편향 = 더하는 수 입력과 상관없이 늘 붙는 몫이라 한 번 더합니다. 영어로 bias 3 파라미터 = 가중치 + 편향 가중치와 편향을 모두 센 수예요. 이 집값 식은 3개 입력 × 가중치 + 편향 답 곱한 몫은 입력 따라 변하고, 더한 몫은 그대로입니다 참고: Google ML 크래시 코스 선형 회귀 · Google ML 용어집 오래 가는 진짜 AI 기본기 03 / 07
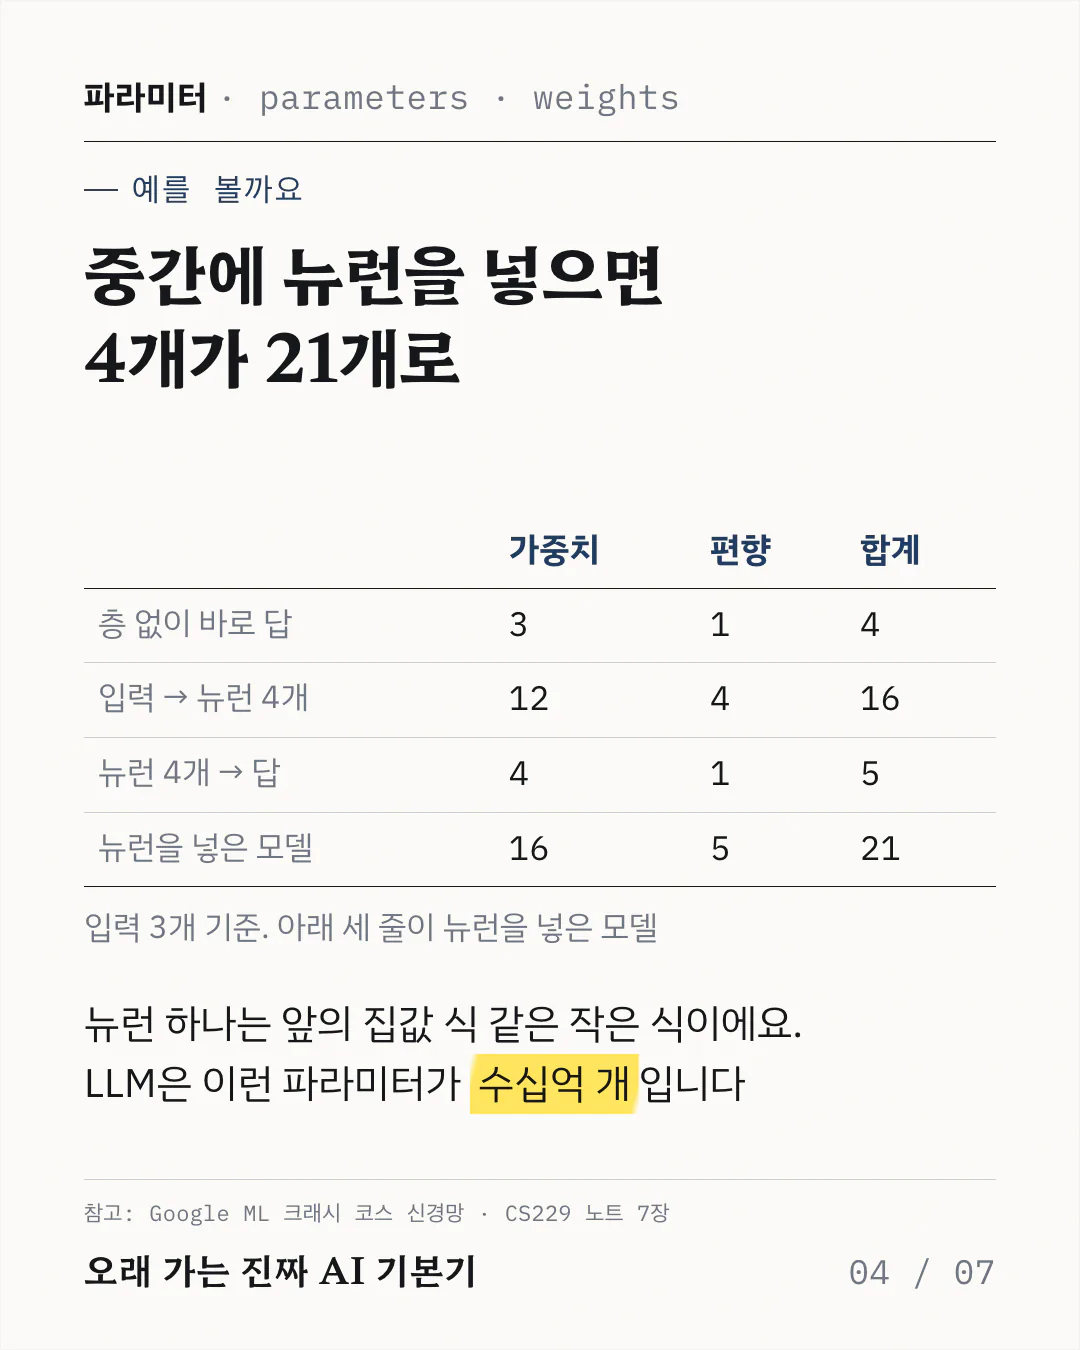
중간에 뉴런을 넣으면 늘어나는 파라미터
뉴런 하나는 입력마다 가중치를 곱해 더하고 편향을 하나 더해요. 앞의 집값 식과 같은 계산이죠. 실제 뉴런은 그 결과를 활성화 함수에 한 번 더 넣는데, 이건 정해진 계산이라 파라미터가 늘지 않아요.
카드 텍스트 보기
파라미터 · parameters · weights 예를 볼까요 중간에 뉴런을 넣으면 4개가 21개로 가중치 편향 합계 층 없이 바로 답 3 1 4 입력 → 뉴런 4개 12 4 16 뉴런 4개 → 답 4 1 5 뉴런을 넣은 모델 16 5 21 입력 3개 기준. 아래 세 줄이 뉴런을 넣은 모델 뉴런 하나는 앞의 집값 식 같은 작은 식이에요. LLM은 이런 파라미터가 수십억 개 입니다 참고: Google ML 크래시 코스 신경망 · CS229 노트 7장 오래 가는 진짜 AI 기본기 04 / 07
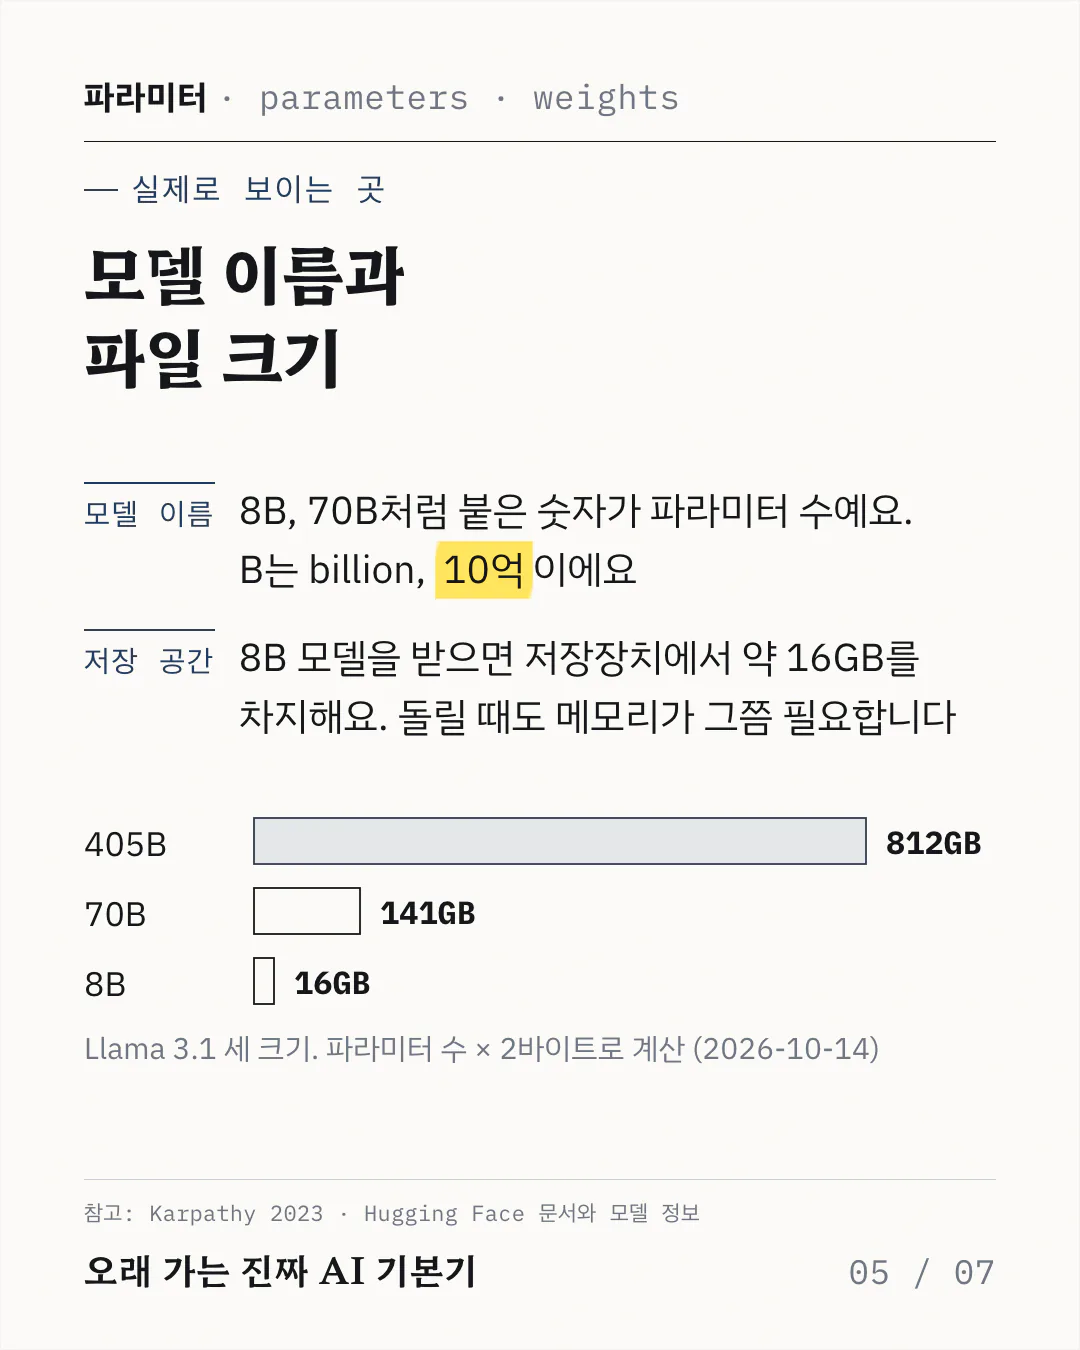
모델 이름과 파일 크기에서 만나는 파라미터
파라미터 하나는 4.5689 같은 소수 하나예요. 이걸 2바이트로 담으니 8B 모델은 80억 3천만 개 × 2바이트, 약 16GB죠. Hugging Face 에 올라온 8B 파일 네 개를 합쳐도 16GB가 나와요.
카드 텍스트 보기
파라미터 · parameters · weights 실제로 보이는 곳 모델 이름과 파일 크기 모델 이름 8B, 70B처럼 붙은 숫자가 파라미터 수예요. B는 billion, 10억 이에요 저장 공간 8B 모델을 받으면 저장장치에서 약 16GB를 차지해요. 돌릴 때도 메모리가 그쯤 필요합니다 405B 812GB 70B 141GB 8B 16GB Llama 3.1 세 크기. 파라미터 수 × 2바이트로 계산 (2026-10-14) 참고: Karpathy 2023 · Hugging Face 문서와 모델 정보 오래 가는 진짜 AI 기본기 05 / 07
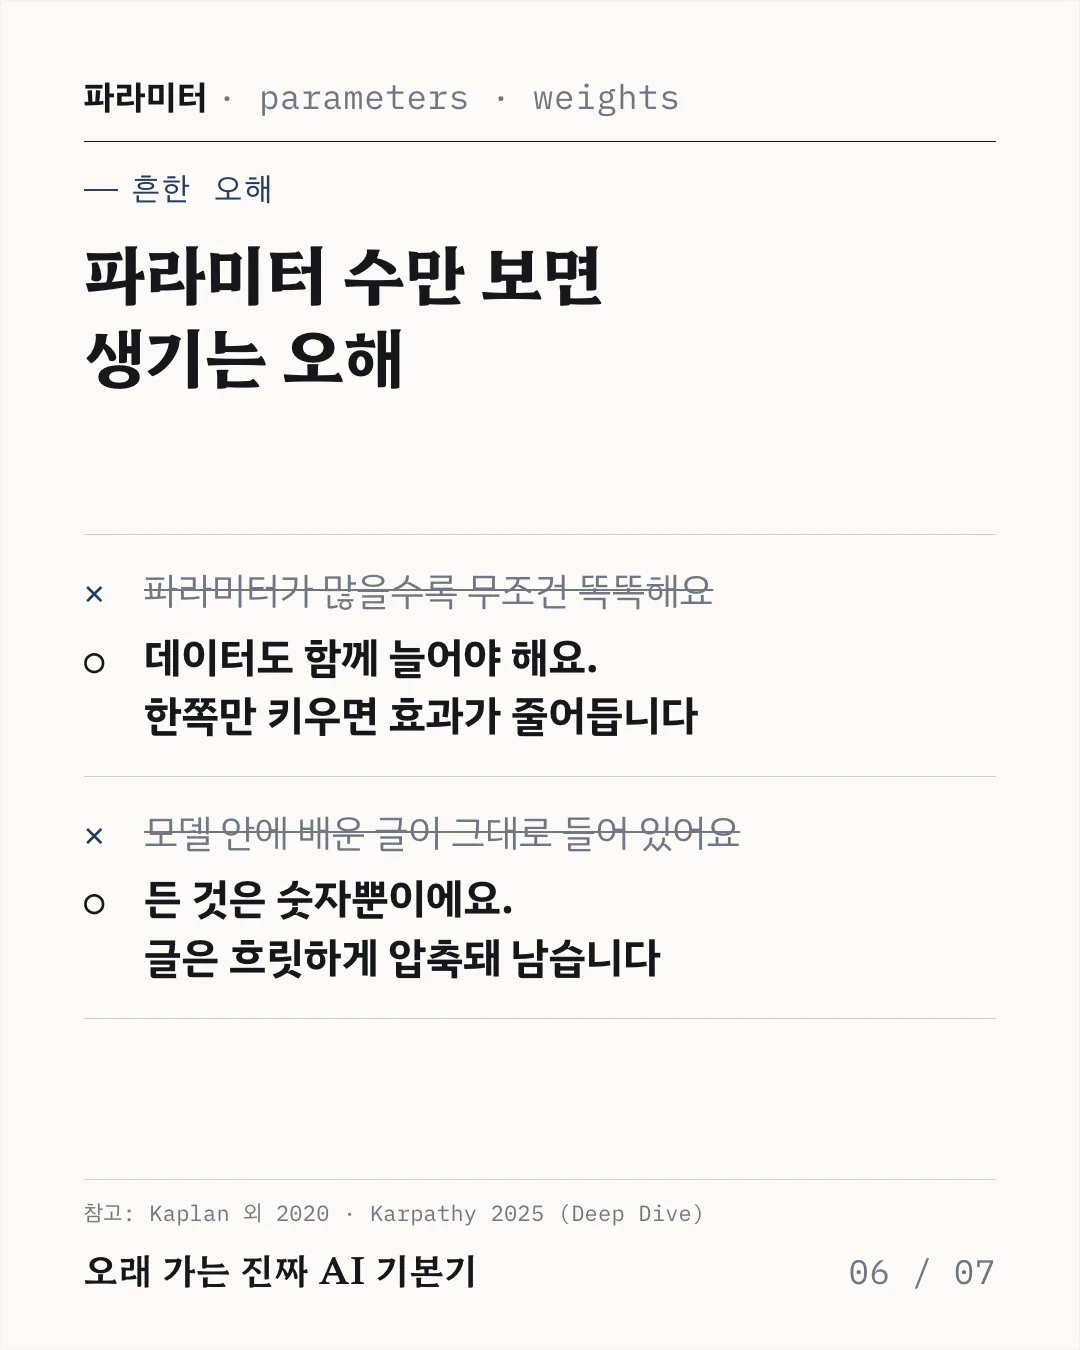
파라미터 수만 보면 생기는 오해
두 번째 오해에는 단서가 하나 붙어요. 위키백과처럼 학습 때 자주 본 글은 모델이 꽤 길게 외워 내기도 하거든요. Karpathy 는 이걸 regurgitation 이라 부르고, 보통은 바라지 않는 일이라고 짚어요.
카드 텍스트 보기
파라미터 · parameters · weights 흔한 오해 파라미터 수만 보면 생기는 오해 ✕ 파라미터가 많을수록 무조건 똑똑해요 ○ 데이터도 함께 늘어야 해요. 한쪽만 키우면 효과가 줄어듭니다 ✕ 모델 안에 배운 글이 그대로 들어 있어요 ○ 든 것은 숫자뿐이에요. 글은 흐릿하게 압축돼 남습니다 참고: Kaplan 외 2020 · Karpathy 2025 (Deep Dive) 오래 가는 진짜 AI 기본기 06 / 07
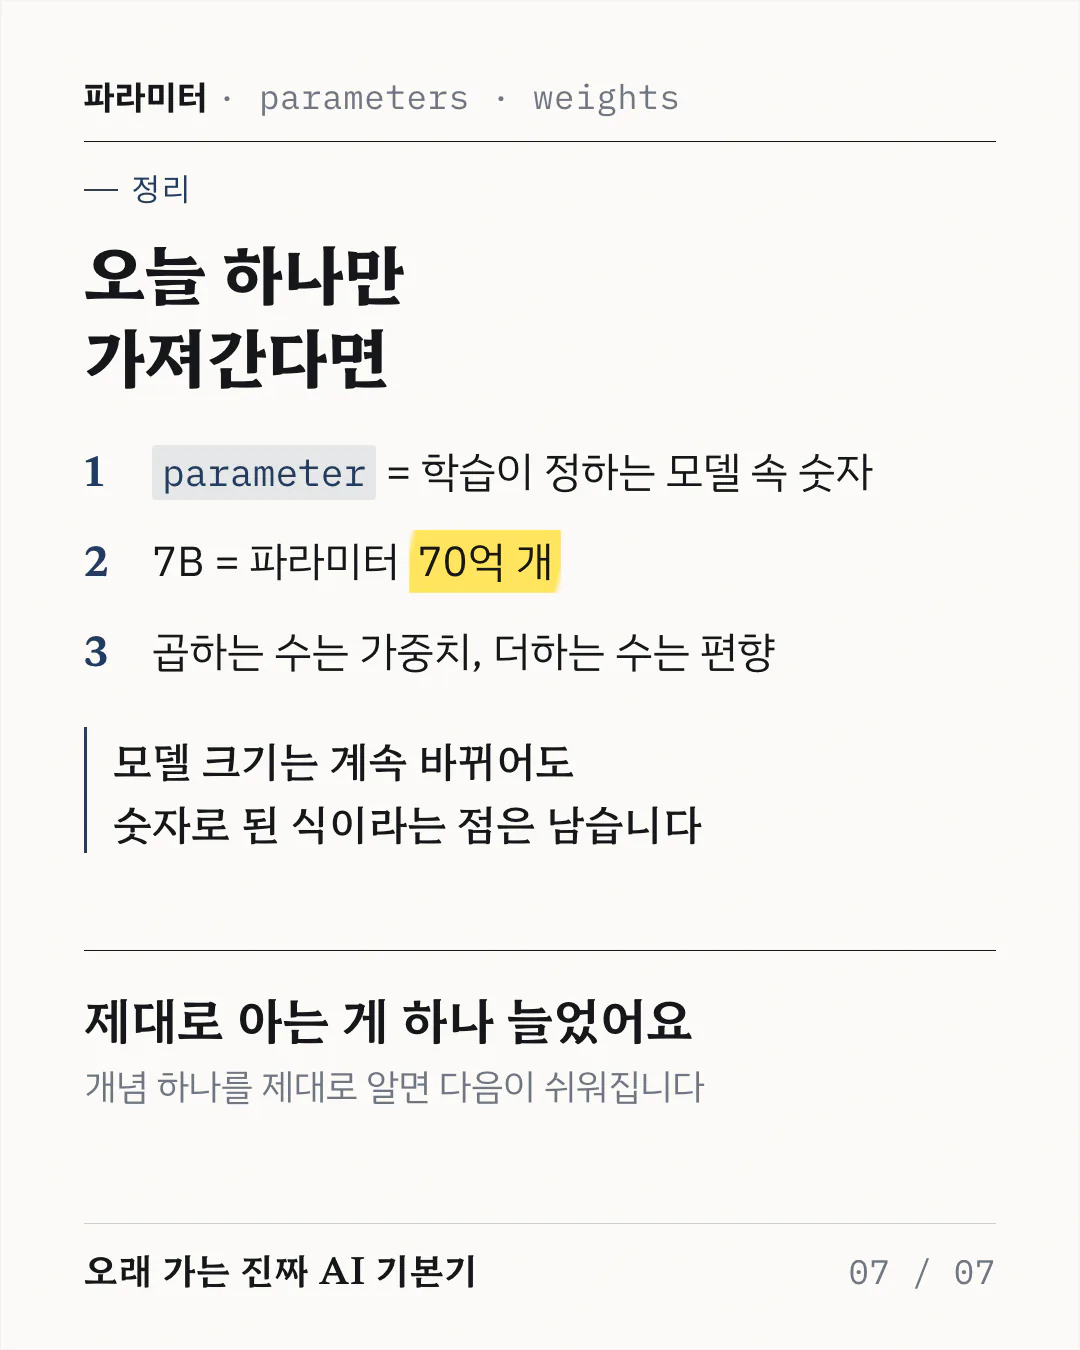
오늘 기억할 세 가지
세 번째 줄의 편향(bias)은 데이터가 한쪽으로 치우쳤다는 그 편향과 다른 뜻이에요. Google 용어집도 두 뜻을 따로 실어 뒀더라고요. 수식 이야기라면 더하는 수로 읽으면 되죠.
카드 텍스트 보기
파라미터 · parameters · weights 정리 오늘 하나만 가져간다면 1 parameter = 학습이 정하는 모델 속 숫자 2 7B = 파라미터 70억 개 3 곱하는 수는 가중치, 더하는 수는 편향 모델 크기는 계속 바뀌어도 숫자로 된 식이라는 점은 남습니다 제대로 아는 게 하나 늘었어요 개념 하나를 제대로 알면 다음이 쉬워집니다 오래 가는 진짜 AI 기본기 07 / 07
출처
- Stanford CS229 Machine Learning 강의 노트 (2026)
- Google 머신러닝 용어집
- Google 머신러닝 크래시 코스 선형 회귀
- Google 머신러닝 크래시 코스 신경망 노드와 숨은 층
- Andrej Karpathy, Intro to Large Language Models (2023)
- Andrej Karpathy, Deep Dive into LLMs like ChatGPT (2025)
- Kaplan 외, Scaling Laws for Neural Language Models (2020)
- Hugging Face Transformers 문서 LLM 추론 최적화 (메모리 계산)
- Hugging Face, Llama 3.1 8B 모델 정보
- Hugging Face, Llama 3.1 70B 모델 정보
- Hugging Face, Llama 3.1 405B 모델 정보
Llama 3.1 파라미터 수와 파일 크기는 2026-10-14 에 Hugging Face 에서 확인했고, 막대의 크기는 파라미터 수에 2바이트를 곱해 직접 계산했어요.
파라미터와 가중치란 무엇일까
모델, 파라미터, 가중치는 따로 외우기보다 한 문장으로 묶는 게 쉬워요. 모델은 답을 내는 식이고, 그 식에 든 숫자가 파라미터거든요. 그중 입력에 곱하는 숫자를 가중치라고 불러요.